Lokale KI im Produktionsbetrieb: vLLM, GPU-Sizing und Enterprise-Deployment
Herausgegeben von der Tanagra Akademie · Zuletzt aktualisiert am
Alle Inhalte sind mit Hilfe von KI entstanden.
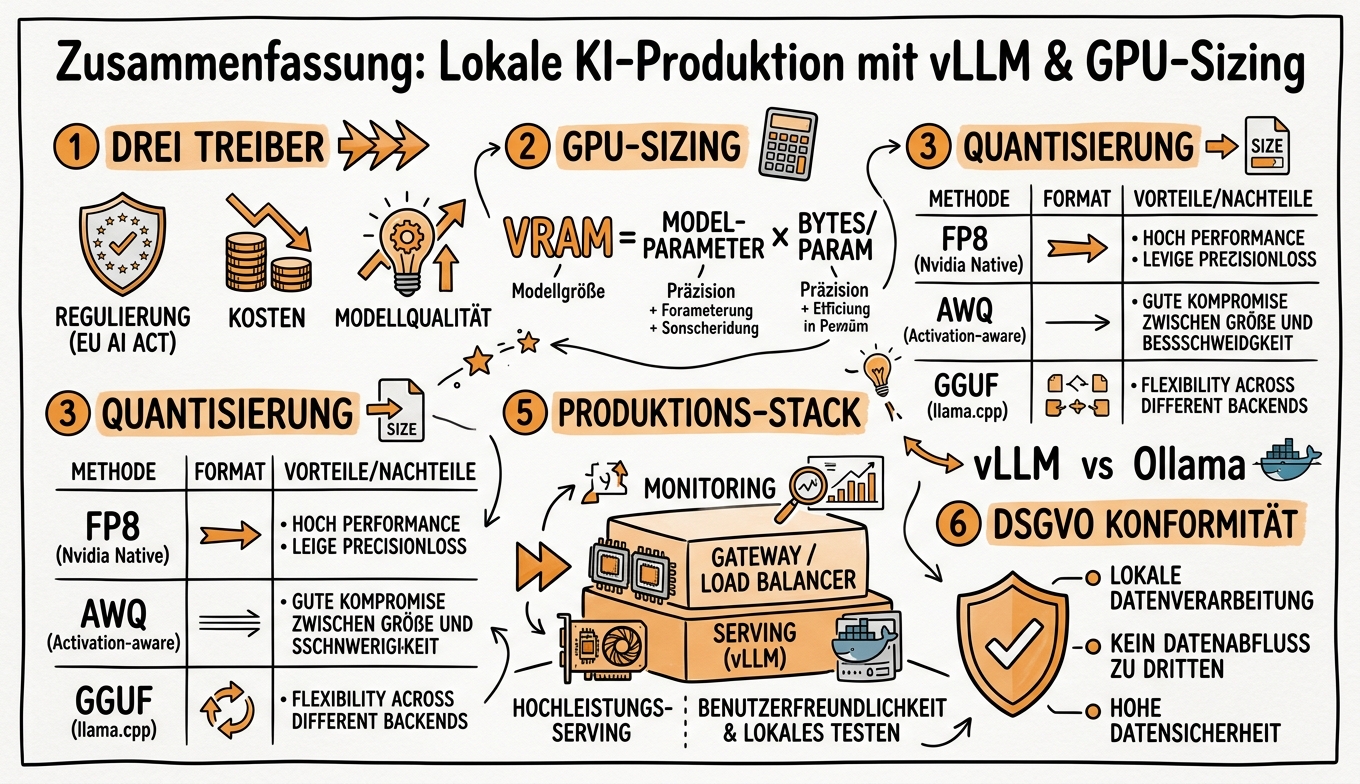
Die Entscheidung zwischen Cloud-APIs und lokaler KI-Inferenz war lange eine rein technische Abwägung. Im Jahr 2026 ist sie zu einer strategischen Frage geworden. Drei Kräfte treiben diese Entwicklung.
Auf einen Blick
| Kategorie | Lokale KI |
|---|---|
| Niveau | Profi |
| Dauer | 1 Std |
| Sprache | Deutsch |
| Zugang | im Abo enthalten |
| Zuletzt aktualisiert |
Inhalt des Kurses
- Lektion 1: Warum lokale Inferenz 2026 zum strategischen Differenzierungsmerkmal wird
- Lektion 2: Hardware-Sizing, wie Sie die richtige GPU-Konfiguration berechnen
- Lektion 3: Quantisierung verstehen, FP8, AWQ, GPTQ und GGUF im Vergleich
- Lektion 4: vLLM vs. Ollama, die richtige Engine für den richtigen Einsatz
- Lektion 5: Production-Deployment, vom Docker-Container zum Enterprise-Stack
- Lektion 6: DSGVO-konformes Deployment und EU-AI-Act-Compliance
- Gesamtzusammenfassung
- Quellenverzeichnis
Quellen und weiterführende Links
Worauf sich dieser Kurs stützt:
- Art. 50 KI-VO (artificialintelligenceact.eu)
- Anthropic 2026 (platform.claude.com)
- Implicator 2026 (implicator.ai)
- DeepSeek-AI 2024 (arxiv.org)
- DeepSeek 2025 (huggingface.co)
- Qwen 2026 (huggingface.co)
- AlternativeTo 2026 (alternativeto.net)
- Meta 2025 (ai.meta.com)
- Google DeepMind 2026 (deepmind.google)
- Hugging Face 2026 (huggingface.co)
- Apple 2026 (apple.com)
- Anyscale 2023 (anyscale.com)
- Kurtic et al. 2024 (arxiv.org)
- vLLM-Dokumentation 2026 (docs.vllm.ai)
- Lin et al. 2024 (arxiv.org)
- Frantar et al. 2023 (arxiv.org)
- ggml 2026 (github.com)
- NVIDIA 2026a (blogs.nvidia.com)
- NVIDIA 2026b (blogs.nvidia.com)
- Ollama FAQ (docs.ollama.com)
- Kwon et al. 2023 (arxiv.org)
- vLLM-Dokumentation (docs.vllm.ai)
- Red Hat 2025 (developers.redhat.com)
- Zheng et al. 2024 (arxiv.org)
- PremAI 2026 (premai.io)
Vollständiger Kurs
Dieser Kurs ist Teil des Akademie-Abos. Enthalten sind alle Kurse des Katalogs, laufende Aktualisierungen und neue Kurse während der Laufzeit.