KI im Klartext: Die Grundlagen, die jeder kennen sollte, bevor er über KI spricht
Herausgegeben von der Tanagra Akademie · Zuletzt aktualisiert am
Alle Inhalte sind mit Hilfe von KI entstanden.
Über KI wird viel geschrieben, auch auf LinkedIn. Oft fallen dabei Begriffe durcheinander: Ein Chatbot wird zum „Agenten“, ein Agent zur unkontrollierbaren Maschine, und regelbasierte Abläufe heißen plötzlich „KI-Automatisierung“. Dieser Kurs räumt auf. Er erklärt ohne Fachjargon, was hinter den wichtigsten Begriffen steckt, und gibt Ihnen ein sicheres Gespür dafür, wann eine Aussage über KI...
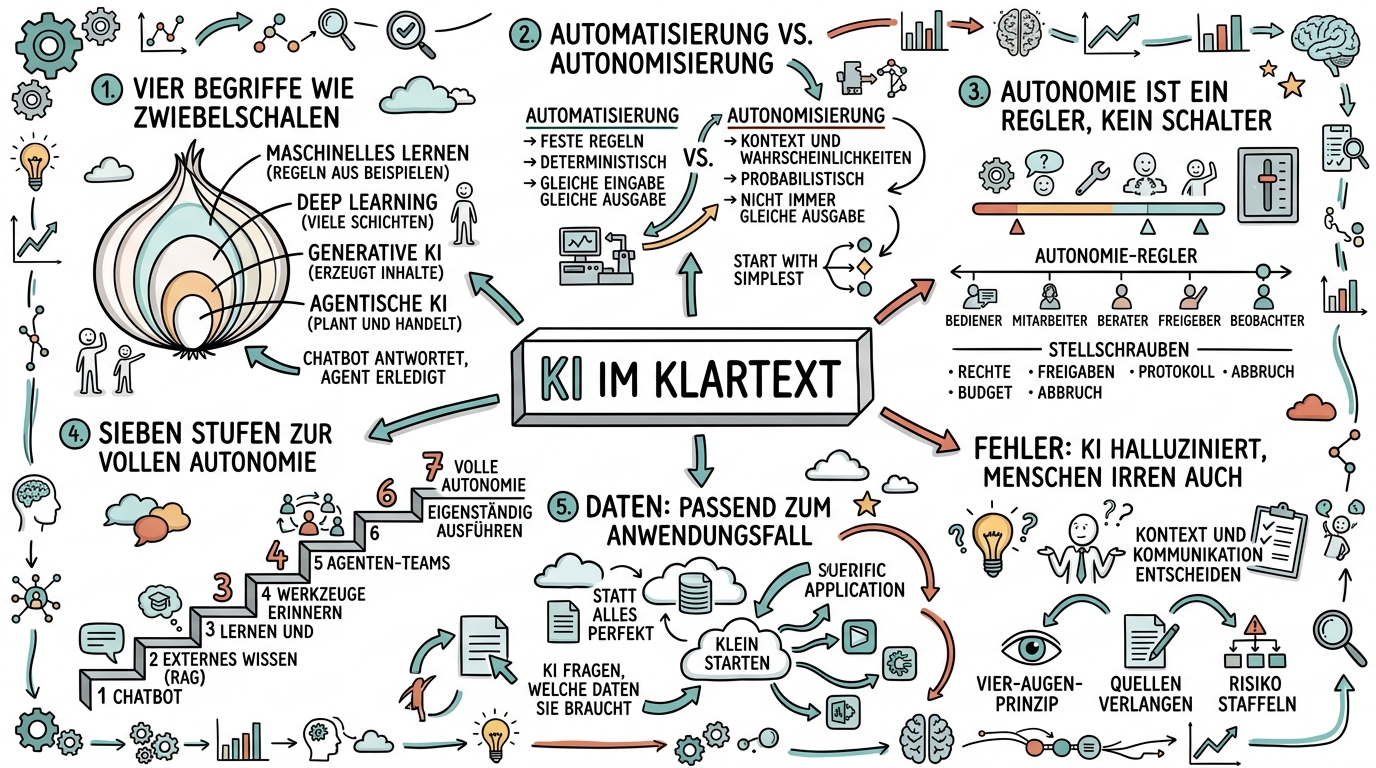
Kurs als Podcast hören
Anna und Max besprechen die wichtigsten Inhalte dieses Kurses. Die Hörfassung ist ebenfalls mit Hilfe von KI entstanden.
Auf einen Blick
| Kategorie | Grundlagen |
|---|---|
| Niveau | Einsteiger |
| Dauer | 50 Min |
| Sprache | Deutsch |
| Zugang | frei zugänglich |
| Zuletzt aktualisiert |
Inhalt des Kurses
- Lektion 1: KI ist nicht gleich KI. Vier Begriffe, die ineinander stecken
- Lektion 2: Automatisierung oder Autonomisierung? Der wichtigste Unterschied, den kaum jemand macht
- Lektion 3: Autonomie ist ein Regler, kein Schalter
- Lektion 4: Vom Text-Werkzeug zum autonomen Agenten. Sieben Entwicklungsstufen
- Lektion 5: Daten sind der Treibstoff, aber kein Großprojekt vorab
- Lektion 6: KI macht Fehler. Menschen auch.
- Lektion 7: Der Klartext-Check. Sieben Aussagen, die Sie jetzt einordnen können
- Zusammenfassung
- Quellen
Quellen und weiterführende Links
Worauf sich dieser Kurs stützt:
- Samuel 1959, IBM Journal (doi.org)
- LeCun, Bengio, Hinton 2015, Nature (nature.com)
- Vaswani et al. 2017 (arxiv.org)
- Anthropic 2024 (anthropic.com)
- Thinking Machines Lab 2025 (thinkingmachines.ai)
- KI-VO Art. 3 Nr. 1, Verordnung (EU) 2024/1689 (eur-lex.europa.eu)
- Bundesnetzagentur 2025 (bundesnetzagentur.de)
- Feng, McDonald, Zhang 2025 (arxiv.org)
- SAE International 2021 (sae.org)
- OpenAI 2025 (openai.com)
- OpenAI 2022 (openai.com)
- Wei et al. 2022 (arxiv.org)
- OpenAI 2024 (openai.com)
- Lewis et al. 2020 (arxiv.org)
- OpenAI 2023 (openai.com)
- Anthropic 2024 (anthropic.com)
- OpenAI 2024 (openai.com)
- Yao et al. 2022 (arxiv.org)
- Shinn et al. 2023 (arxiv.org)
- Anthropic 2025 (anthropic.com)
- METR 2025 (arxiv.org)
- OpenAI 2025 (openai.com)
- Gartner 2025 (gartner.com)
- Gartner 2024 (gartner.com)
- Kalai et al. 2025 (arxiv.org)
Kursinhalt
KI im Klartext: Die Grundlagen, die jeder kennen sollte, bevor er über KI spricht
Über KI wird viel geschrieben, auch auf LinkedIn. Oft fallen dabei Begriffe durcheinander: Ein Chatbot wird zum „Agenten“, ein Agent zur unkontrollierbaren Maschine, und regelbasierte Abläufe heißen plötzlich „KI-Automatisierung“. Dieser Kurs räumt auf. Er erklärt ohne Fachjargon, was hinter den wichtigsten Begriffen steckt, und gibt Ihnen ein sicheres Gespür dafür, wann eine Aussage über KI stimmt und wann nicht.
Zielgruppe: Alle, die KI im Beruf nutzen, darüber entscheiden oder darüber reden, ohne Informatik studiert zu haben. Führungskräfte, Fachleute, Selbständige, Teams im Mittelstand.
Was Sie nach dem Kurs können:
- Maschinelles Lernen, Deep Learning, generative KI und agentische KI sauber voneinander unterscheiden
- Erklären, warum Autonomie bei KI ein Regler ist und kein Schalter
- Den Unterschied zwischen Automatisierung (deterministisch) und Autonomisierung (probabilistisch) begründen
- Die sieben Entwicklungsstufen vom Text-Werkzeug bis zum proaktiven Agenten einordnen und die Rolle des Menschen auf jeder Stufe benennen
- Realistisch einschätzen, welche Daten KI braucht und wie Fehler von KI und Mensch zusammenhängen
Dauer: etwa 50 Minuten, sieben Lektionen
Lektion 1: KI ist nicht gleich KI. Vier Begriffe, die ineinander stecken
Lernziel: Sie können maschinelles Lernen, Deep Learning, generative KI und agentische KI in eigenen Worten unterscheiden und wissen, wie sie zusammenhängen.
Stellen Sie sich die vier Begriffe wie Zwiebelschalen vor. Außen steht der Oberbegriff Künstliche Intelligenz, innen werden die Begriffe immer spezieller. Wer das Bild im Kopf hat, erkennt sofort, wenn in einem Beitrag Äpfel mit Birnen verglichen werden.
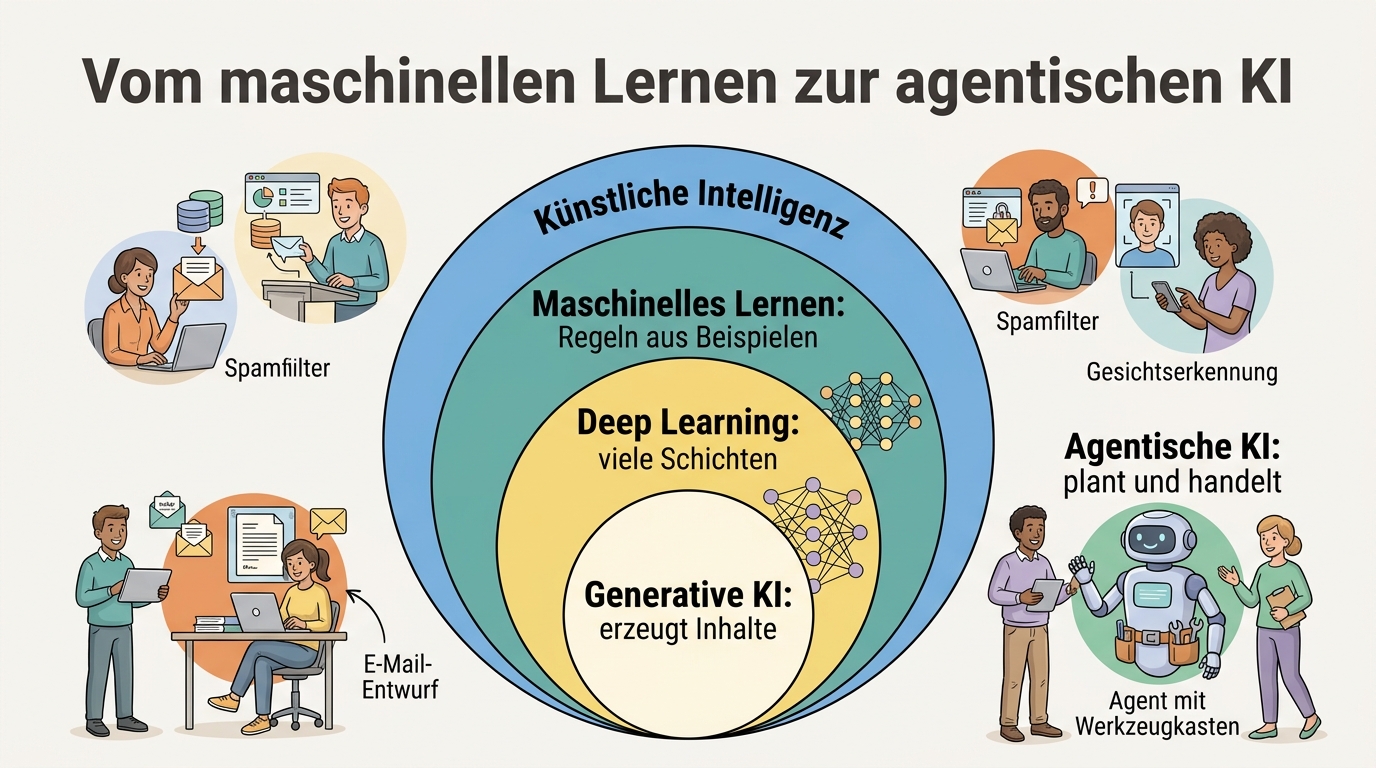
1. Maschinelles Lernen (Machine Learning) Klassische Software folgt Regeln, die ein Mensch aufgeschrieben hat. Beim maschinellen Lernen ist das anders: Das System leitet die Regeln aus Beispielen selbst ab. Man zeigt ihm tausende Rechnungen, die korrekt oder fehlerhaft verbucht wurden, und es lernt die Muster, an denen man Fehler erkennt. Der Gedanke ist alt. Arthur Samuel beschrieb schon 1959 ein Programm, das Dame spielen lernte, indem es aus eigenen Partien Schlüsse zog (Samuel 1959, IBM Journal). Typische Anwendungen heute: Spamfilter, Betrugserkennung, Absatzprognosen.
2. Deep Learning Deep Learning ist eine besondere Form des maschinellen Lernens. Es nutzt künstliche neuronale Netze mit vielen hintereinander geschalteten Schichten. „Tief“ heißt hier: viele Schichten, nicht tiefes Denken. Jede Schicht erkennt etwas abstraktere Merkmale als die vorherige, bei Bildern etwa erst Kanten, dann Formen, dann Gesichter (LeCun, Bengio, Hinton 2015, Nature). Deep Learning steckt in Spracherkennung, Bilderkennung und Übersetzung.
3. Generative KI Generative KI ist Deep Learning, das neue Inhalte erzeugt: Texte, Bilder, Code, Audio. Die heutigen Sprachmodelle wie ChatGPT, Claude oder Gemini beruhen auf der Transformer-Architektur (Vaswani et al. 2017). Vereinfacht gesagt sagen sie Wort für Wort voraus, was im jeweiligen Zusammenhang am wahrscheinlichsten als Nächstes kommt. Das klingt banal, reicht aber, um Briefe zu schreiben, Verträge zusammenzufassen und Programme zu entwerfen.
4. Agentische KI Agentische KI nutzt ein generatives Modell als „Denkzentrale“ und gibt ihm zusätzlich Werkzeuge, Zugriff auf Informationen und die Möglichkeit, mehrere Schritte selbst zu planen. Anthropic beschreibt den Unterschied so: Bei einem Agenten steuert das Sprachmodell seine Abläufe und seinen Werkzeuggebrauch selbst, statt einem fest programmierten Pfad zu folgen (Anthropic 2024). Ein Chatbot antwortet. Ein Agent erledigt.
| Begriff | Kernfrage | Beispiel |
|---|---|---|
| Maschinelles Lernen | Welches Muster steckt in den Daten? | Betrugserkennung bei Kartenzahlungen |
| Deep Learning | Welche komplexen Muster erkennt ein vielschichtiges Netz? | Gesichtserkennung im Smartphone |
| Generative KI | Was wäre eine passende neue Antwort? | Entwurf einer Kunden-E-Mail |
| Agentische KI | Welche Schritte führen zum Ziel, und welches Werkzeug brauche ich dafür? | Angebot recherchieren, kalkulieren, als Entwurf ablegen |
Typischer Denkfehler: „Wir nutzen schon lange KI, wir haben ja eine Excel-Makro-Automatisierung.“ Ein Makro ist eine feste Regel, die ein Mensch geschrieben hat. Das ist nützlich, aber kein maschinelles Lernen.
Kernpunkte:
- Die vier Begriffe stecken ineinander: Agentische KI baut auf generativer KI auf, diese auf Deep Learning, dieses auf maschinellem Lernen.
- Maschinelles Lernen heißt: Regeln aus Beispielen ableiten statt von Hand programmieren.
- Ein Chatbot antwortet, ein Agent plant und handelt in mehreren Schritten.
Lektion 2: Automatisierung oder Autonomisierung? Der wichtigste Unterschied, den kaum jemand macht
Lernziel: Sie können erklären, warum regelbasierte Automatisierung deterministisch arbeitet, generative und agentische KI dagegen probabilistisch, und warum wir deshalb besser von Autonomisierung sprechen.
Automatisierung: gleiche Eingabe, gleiche Ausgabe Klassische Automatisierung folgt festen Regeln. „Wenn eine Rechnung über 5.000 Euro eingeht, schicke sie an die Abteilungsleitung.“ Geben Sie dieselbe Rechnung hundertmal ein, passiert hundertmal genau dasselbe. Fachleute nennen das deterministisch: Das Ergebnis ist durch die Eingabe vollständig bestimmt. Genau das will man bei Gehaltsabrechnungen, Buchungsregeln oder Ampelschaltungen.
Autonomisierung: Handeln aus dem Kontext heraus Generative und agentische KI arbeiten anders. Sie berechnen Wahrscheinlichkeiten für mögliche Antworten und wählen daraus aus. Dieselbe Frage kann deshalb unterschiedliche, oft gleichwertige Antworten erzeugen. Das ist probabilistisch. Selbst wenn man die Zufallskomponente technisch auf null stellt, bleibt im praktischen Betrieb eine Restschwankung: In einem Versuch des Thinking Machines Lab lieferte ein großes Sprachmodell bei 1.000 identischen Anfragen mit Temperatur 0 genau 80 verschiedene Antworten. Die ersten 102 Wörter beziehungsweise Wortteile waren überall gleich, danach trennten sich die Wege (Thinking Machines Lab 2025). Die Forscher zeigen auch, dass sich das mit erheblichem Aufwand technisch abstellen lässt. Im Alltag der gängigen Werkzeuge gilt aber: Rechnen Sie mit Varianz.
Darum schlagen wir in der Akademie vor, zwei Wörter auseinanderzuhalten:
| Automatisierung | Autonomisierung | |
|---|---|---|
| Grundlage | Feste Regeln | Kontext, Ziel, Wahrscheinlichkeiten |
| Verhalten | Deterministisch | Probabilistisch |
| Gleiche Eingabe | Immer gleiche Ausgabe | Ähnliche, nicht zwingend gleiche Ausgabe |
| Stärke | Verlässlich, prüfbar, billig | Flexibel bei Unvorhergesehenem, versteht Sprache und Absicht |
| Schwäche | Bricht bei jeder Ausnahme | Braucht Leitplanken und Prüfung |
| Typischer Einsatz | Buchungsregeln, Datenübertragung | Anfragen beantworten, recherchieren, Entwürfe erstellen |
Warum das Wort wichtig ist: Wer von „KI-Automatisierung“ spricht, weckt die Erwartung einer Maschine, die immer gleich funktioniert. Wer von Autonomisierung spricht, macht klar: Hier entscheidet ein System im Rahmen eines Auftrags selbst, wie es vorgeht. Daraus folgen andere Fragen: Welchen Spielraum gebe ich? Wo will ich gefragt werden? Wie prüfe ich das Ergebnis?
Kein Entweder-oder. In der Praxis werden beide Welten kombiniert. Anthropic unterscheidet „Workflows“, in denen Sprachmodelle und Werkzeuge über vorab festgelegte Pfade verbunden sind, von „Agenten“, die ihren Weg selbst bestimmen. Die Empfehlung lautet ausdrücklich, mit der einfachsten Lösung zu beginnen. Für viele Anwendungen reicht ein gut vorbereiteter einzelner Modellaufruf mit passenden Informationen (Anthropic 2024). Feste Regeln bleiben dort, wo Verlässlichkeit zählt. Autonomie kommt dort hinzu, wo Flexibilität einen echten Mehrwert bringt.
Praxistipp: Fragen Sie bei jedem Prozess zuerst: Gibt es hier eine eindeutige Regel? Wenn ja, automatisieren Sie klassisch. Erst wo Sprache, Ausnahmen und Urteilsvermögen ins Spiel kommen, lohnt sich Autonomisierung.
Kernpunkte:
- Automatisierung ist deterministisch: gleiche Eingabe, gleiche Ausgabe.
- Generative und agentische KI sind probabilistisch: Sie handeln aus dem Kontext und liefern nicht zwingend zweimal dasselbe.
- „Autonomisierung“ beschreibt diesen Unterschied ehrlicher als „KI-Automatisierung“.
Lektion 3: Autonomie ist ein Regler, kein Schalter
Lernziel: Sie können erklären, dass agentische KI in unterschiedlichen Autonomiegraden betrieben wird und dass der Mensch diesen Grad festlegt.
In vielen Beiträgen klingt „KI-Agent“ nach einem Programm, das einmal gestartet wird und dann unkontrolliert tut, was es will. Das ist ein Zerrbild. Autonomie ist kein An-Aus-Schalter, sondern ein Regler, und wer einen Agenten einsetzt, stellt ihn ein.
Selbst das Gesetz denkt in Graden. Die europäische KI-Verordnung definiert ein KI-System als „ein maschinengestütztes System, das für einen in unterschiedlichem Grade autonomen Betrieb ausgelegt ist“ (KI-VO Art. 3 Nr. 1, Verordnung (EU) 2024/1689). Die Leitlinien der EU-Kommission vom 6. Februar 2025 nennen „unterschiedliche Autonomiegrade“ ausdrücklich als eines von sieben Hauptelementen dieser Definition (Bundesnetzagentur 2025).
Autonomie ist eine Entscheidung, keine Eigenschaft. Forschende der University of Washington haben für das Knight First Amendment Institute ein Stufenmodell entwickelt. Ihre zentrale These: Wie autonom ein Agent arbeitet, ist eine bewusste Gestaltungsentscheidung und unabhängig davon, was er technisch könnte (Feng, McDonald, Zhang 2025). Die Stufen beschreiben, welche Rolle der Mensch übernimmt:
| Stufe | Rolle des Menschen | Was das bedeutet |
|---|---|---|
| 1 | Bediener | Der Mensch steuert und entscheidet, der Agent führt aus. |
| 2 | Mitarbeiter | Mensch und Agent planen und erledigen gemeinsam. |
| 3 | Berater | Der Agent führt, fragt aber nach Fachwissen und Vorlieben. |
| 4 | Freigeber | Der Agent meldet sich nur bei riskanten oder vorab festgelegten Situationen. |
| 5 | Beobachter | Der Agent arbeitet voll autonom, der Mensch überwacht. |
Ein bekanntes Beispiel aus dem Straßenverkehr folgt derselben Logik: Die Norm SAE J3016 unterscheidet beim Autofahren sechs Stufen von 0 (keine Automatisierung) bis 5 (vollständig fahrerlos) (SAE International 2021). Niemand würde sagen, ein Auto mit Spurhalteassistent „fahre alleine“.
So sieht das im Alltag aus. Als OpenAI im Juli 2025 den „ChatGPT agent“ vorstellte, wurde er so gebaut, dass er vor folgenreichen Aktionen um Erlaubnis fragt. Nutzer können ihn jederzeit unterbrechen, den Browser übernehmen oder die Aufgabe stoppen (OpenAI 2025). Das ist Stufe 3 bis 4, nicht Stufe 5.
Die Stellschrauben, mit denen Sie Autonomie regeln:
- Rechte: Darf der Agent nur lesen oder auch schreiben, senden, bezahlen?
- Freigaben: Bei welchen Schritten muss ein Mensch zustimmen?
- Budget: Wie viel Zeit, Geld oder Rechenleistung darf er verbrauchen?
- Protokoll: Wird jeder Schritt nachvollziehbar festgehalten?
- Abbruch: Kann jemand jederzeit eingreifen?
Reflexionsfrage: Nehmen Sie eine Aufgabe aus Ihrem Alltag, die ein Agent übernehmen könnte. Auf welche Stufe würden Sie ihn stellen, und was müsste passieren, damit Sie ihm eine Stufe mehr zutrauen?
Kernpunkte:
- Autonomie ist ein Regler, den der Mensch einstellt, kein Schalter, der einmal umgelegt wird.
- Die EU-KI-Verordnung definiert KI ausdrücklich über unterschiedliche Autonomiegrade.
- Rechte, Freigaben, Budget, Protokoll und Abbruchmöglichkeit sind Ihre Stellschrauben.
Lektion 4: Vom Text-Werkzeug zum autonomen Agenten. Sieben Entwicklungsstufen
Lernziel: Sie können die Entwicklung seit dem Start von ChatGPT in sieben Stufen nachzeichnen, wissen, welche Rolle der Mensch auf jeder Stufe hat, und können erklären, was „Lernen“ bei KI wirklich bedeutet.
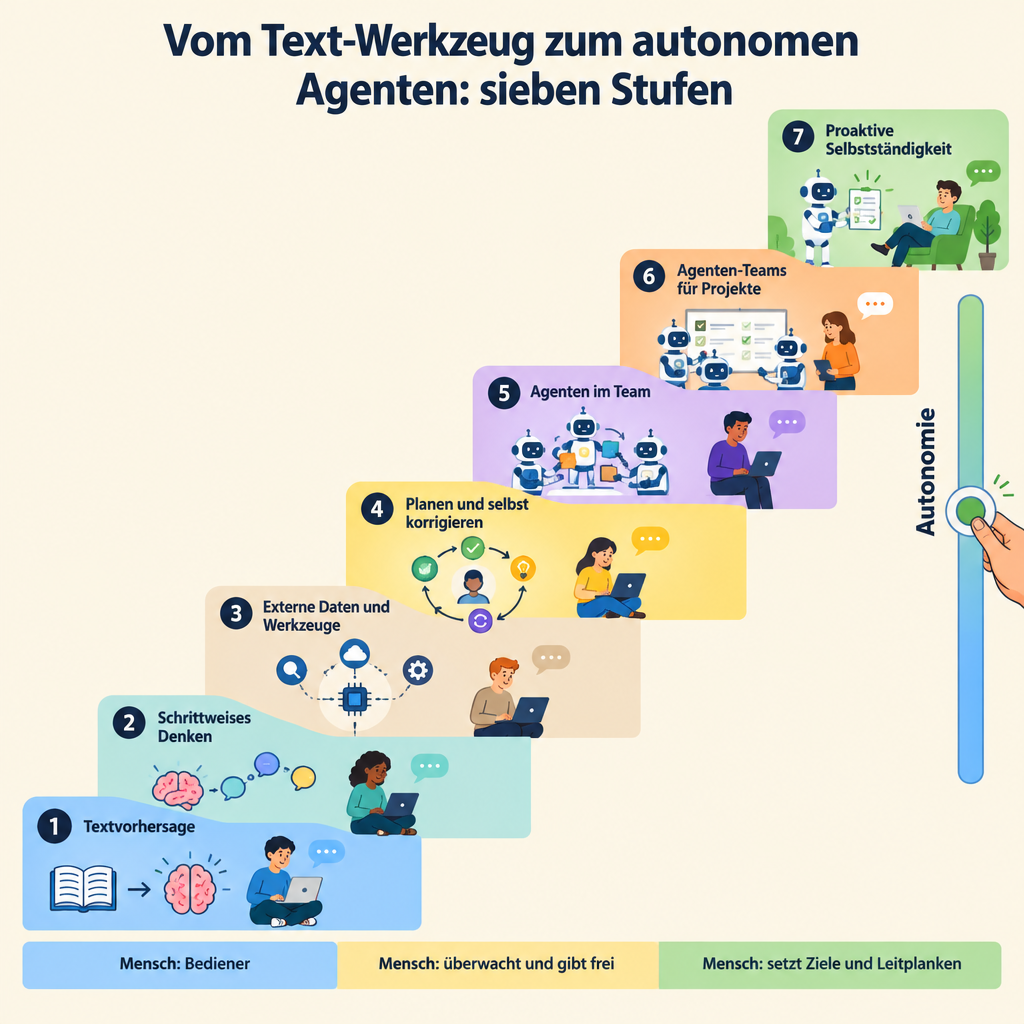
Seit OpenAI ChatGPT am 30. November 2022 veröffentlicht hat (OpenAI 2022), hat sich KI in schnellen Schritten weiterentwickelt. Wir fassen das in der Akademie als sieben Stufen zusammen. Das ist ein didaktisches Modell, kein Industriestandard: Jede Stufe baut auf der vorherigen auf, und in der Praxis laufen viele davon parallel. Die Stufen beschreiben zwei Dinge zugleich: was das System kann und wie viel Autonomie wir ihm geben.
Stufen 1 und 2: Reaktive Sprachwerkzeuge
Das System antwortet, wenn Sie fragen, und tut sonst nichts. Der Mensch ist Bediener: Er steuert jeden einzelnen Austausch selbst. Autonomie: keine.
Stufe 1: Statistische Textvorhersage. Ein Sprachmodell sagt Wort für Wort voraus, was im jeweiligen Zusammenhang am wahrscheinlichsten als Nächstes kommt. Grundlage ist die Transformer-Architektur (Vaswani et al. 2017). Das Modell antwortet aus dem Wissen, das es im Training aufgenommen hat. Es kennt nichts, was nach seinem Trainingsstichtag passiert ist, und nichts aus Ihrem Unternehmen.
Stufe 2: Strukturiertes, schrittweises Denken. Modelle lösen Aufgaben besser, wenn sie Zwischenschritte formulieren, statt sofort zu antworten. Forschende von Google zeigten 2022, dass solche Gedankenketten („Chain of Thought“) die Leistung bei Rechen-, Logik- und Alltagsaufgaben deutlich verbessern (Wei et al. 2022). Seit September 2024 gibt es Modelle, die dieses Nachdenken im Training gelernt haben: OpenAI o1 wurde per Verstärkungslernen darauf trainiert, vor der Antwort eine Gedankenkette zu bilden, und wird besser, je mehr Zeit es zum Nachdenken bekommt (OpenAI 2024). Man spricht von „Reasoning-Modellen“. Wichtig: Das Modell denkt gründlicher, aber es handelt noch nicht.
Stufen 3 und 4: Agenten
Jetzt greift das System selbst auf die Welt zu und erledigt mehrere Schritte. Der Mensch überwacht und gibt frei. Autonomie: gering bis mittel.
Stufe 3: Zugriff auf externe Datenquellen und Werkzeuge. Das Modell holt sich Informationen von außerhalb des Gelernten: Websuche, Unternehmensdokumente, Datenbanken, Programmschnittstellen (APIs). Das Prinzip, ein Sprachmodell mit einem durchsuchbaren Wissensspeicher zu verbinden, heißt Retrieval-Augmented Generation, kurz RAG, und wurde 2020 beschrieben (Lewis et al. 2020). Im Juni 2023 führte OpenAI das Function Calling ein: Das Modell gibt an, welches Werkzeug es mit welchen Angaben aufrufen möchte, und ein Programm führt den Aufruf aus (OpenAI 2023). Im November 2024 veröffentlichte Anthropic das Model Context Protocol (MCP) als offenen Standard, um KI-Systeme einheitlich mit Datenquellen und Werkzeugen zu verbinden (Anthropic 2024). Stufe 3 ist die Schwelle: Das System reagiert noch auf Ihre Anfrage, entscheidet aber schon selbst, wo es nachschlägt und welches Werkzeug es nutzt.
Und wo bleibt das Lernen? Mit dem Zugriff auf externe Daten kommt oft der Satz „Die KI lernt mit jedem Gespräch dazu.“ Hier lohnt ein genauer Blick, denn bei KI gibt es zwei Arten von „Lernen“:
- Lernen im Training: Das Modell wird über Wochen mit riesigen Datenmengen trainiert. Dabei verändern sich seine inneren Gewichte. Das passiert beim Anbieter, nicht in Ihrem Gespräch.
- Lernen im Einsatz: Während Sie arbeiten, verändert sich das Modell nicht. Es „lernt“ nur in dem Sinn, dass es Informationen im aktuellen Gespräch, aus angebundenen Quellen oder aus gespeicherten Notizen berücksichtigt. Eine solche Gedächtnisfunktion hat OpenAI im Februar 2024 eingeführt. Nutzer können sie einsehen, löschen und abschalten (OpenAI 2024).
Die Aussage stimmt also nur im zweiten Sinn: Die KI merkt sich etwas, sie wird dadurch aber nicht klüger. Ob ein Anbieter Gespräche später für neues Training verwendet, ist eine Frage der Datenschutzeinstellungen, nicht der Technik im Gespräch.
Stufe 4: Iterative Aufgabenplanung und Selbstkorrektur. Der Agent zerlegt eine Aufgabe in Schritte, führt sie aus, prüft das Zwischenergebnis und korrigiert seinen Kurs. Das Grundmuster wurde 2022 unter dem Namen ReAct beschrieben: Das Modell wechselt zwischen Nachdenken und Handeln, und die Ergebnisse jeder Handlung fließen in den nächsten Denkschritt ein (Yao et al. 2022). Ein Jahr später zeigte der Ansatz „Reflexion“, dass Agenten sich verbessern können, indem sie ihre Fehler in Worten auswerten und diese Notizen beim nächsten Versuch nutzen, ohne dass das Modell neu trainiert wird (Shinn et al. 2023). Im Alltag angekommen ist das zum Beispiel mit dem „ChatGPT agent“ von Juli 2025, der Webbrowser, Recherche und Codeausführung verbindet. Er fragt vor folgenreichen Aktionen um Erlaubnis, und Nutzer können jederzeit eingreifen (OpenAI 2025). Genau das meint „überwachen und freigeben“.
Stufen 5 bis 7: Autonome Systeme
Hier arbeitet die KI über längere Strecken selbständig. Der Mensch rückt in die Rolle eines Aufsichtsrats: Er setzt Ziele, Leitplanken und Budgets und schaut auf die Ergebnisse. Autonomie: hoch bis maximal.
Stufe 5: Agenten im Team. Statt eines Alleskönners teilen sich spezialisierte Agenten eine Aufgabe. Ein leitender Agent plant, verteilt Teilaufgaben an Unteragenten und führt die Ergebnisse zusammen. In einem Rechercheversuch von Anthropic schnitt ein solches Team um 90,2 Prozent besser ab als ein einzelner Agent. Der Preis: Mehragentensysteme verbrauchten etwa 15-mal so viele Tokens wie ein normaler Chat (Anthropic 2025). Zusammenarbeit lohnt sich also für wertvolle, gut teilbare Aufgaben, nicht für jede Kleinigkeit.
Stufe 6: Agenten-Teams für komplexe Projekte. Aus einzelnen Aufgaben werden Projekte, die sich über Stunden erstrecken, mit vielen Teilschritten, Zwischenständen und Abhängigkeiten. Wie schnell diese Fähigkeit wächst, misst die Forschungsorganisation METR: Die Länge der Aufgaben, die KI-Agenten mit 50 Prozent Erfolgsquote bewältigen, hat sich über sechs Jahre etwa alle sieben Monate verdoppelt (METR 2025). Je länger ein Agent allein arbeitet, desto wichtiger werden Protokoll, Budget und Abbruchmöglichkeit aus Lektion 3.
Stufe 7: Proaktive Selbstständigkeit. Bis Stufe 6 wartet die KI auf einen Auftrag. Auf Stufe 7 wird sie von sich aus tätig: Sie arbeitet dauerhaft im Hintergrund und informiert den Menschen nur noch über Ergebnisse. Ein frühes, eng begrenztes Beispiel ist „ChatGPT Pulse“, das OpenAI am 25. September 2025 als Vorschau für Pro-Nutzer eingeführt hat: ChatGPT recherchiert über Nacht auf Basis von Gesprächsverlauf, Gedächtnis und Rückmeldungen und liefert morgens persönliche Kurzbriefings (OpenAI 2025). Auch hier gilt: Ob und wofür man einer KI diese Selbstständigkeit gibt, bleibt eine bewusste Entscheidung, abhängig von Risiko, Rechten und Prüfmöglichkeiten. Der Mensch gibt die Kontrolle nicht ab, er übt sie anders aus.
| Stufe | Was neu hinzukommt | Beispiel | Rolle des Menschen |
|---|---|---|---|
| 1 Textvorhersage | Antworten aus Trainingswissen | ChatGPT, November 2022 | Bediener |
| 2 Schrittweises Denken | Zwischenschritte vor der Antwort | Chain of Thought 2022, OpenAI o1 2024 | Bediener |
| 3 Externe Daten und Werkzeuge | Suche, Dokumente, APIs | RAG 2020, Function Calling 2023, MCP 2024 | überwacht und gibt frei |
| 4 Planen und selbst korrigieren | Schleife aus Planen, Handeln, Prüfen | ReAct 2022, ChatGPT agent 2025 | überwacht und gibt frei |
| 5 Agenten im Team | Arbeitsteilung spezialisierter Agenten | Anthropic Research-System 2025 | setzt Ziele und Leitplanken |
| 6 Agenten-Teams für Projekte | Lange, mehrstufige Vorhaben | METR-Messungen 2025 | setzt Ziele und Leitplanken |
| 7 Proaktive Selbstständigkeit | Wird ohne Auftrag tätig, meldet Ergebnisse | ChatGPT Pulse 2025 (Vorschau) | setzt Ziele und Leitplanken |
Verbindung zu Lektion 3: Die Rollen „Bediener“, „überwacht und gibt frei“ und „setzt Ziele und Leitplanken“ entsprechen grob den Rollen Bediener, Freigeber und Beobachter im Stufenmodell von Feng, McDonald und Zhang. Dass ein System Stufe 7 technisch beherrscht, heißt nicht, dass Sie es auf Stufe 7 betreiben müssen.
Kernpunkte:
- Stufen 1 und 2 sind reaktive Sprachwerkzeuge, Stufen 3 und 4 Agenten, Stufen 5 bis 7 autonome Systeme.
- Mit jeder Stufe wandelt sich die Rolle des Menschen: vom Bediener über den Prüfer zum Aufsichtsrat, der Ziele und Leitplanken setzt.
- „Lernen“ heißt bei KI meistens: im Training gelernt, im Einsatz nur erinnert.
- Mehr Autonomie bringt mehr Leistung, kostet aber mehr Rechenleistung und braucht mehr Leitplanken.
Lektion 5: Daten sind der Treibstoff, aber kein Großprojekt vorab
Lernziel: Sie verstehen, warum Daten für KI entscheidend sind, und wissen, wie Sie KI selbst nutzen, um herauszufinden, welche Daten Sie wirklich brauchen.
Eine KI ist nur so gut wie die Informationen, mit denen sie arbeitet. Ein Agent, der Kundenanfragen beantworten soll, aber keine aktuellen Preise kennt, wird falsche Angebote machen. Das Marktforschungsunternehmen Gartner befragte im Juli 2024 1.203 Verantwortliche für Datenmanagement: 63 Prozent der Organisationen hatten keine passenden Datenpraktiken für KI oder waren sich nicht sicher. Gartner erwartet, dass Unternehmen bis Ende 2026 60 Prozent der KI-Projekte aufgeben, die nicht durch KI-taugliche Daten gestützt sind (Gartner 2025).
Der falsche Schluss daraus: „Dann müssen wir erst alle Daten neu ordnen, bevor wir mit KI anfangen.“ Das führt zu jahrelangen Projekten ohne Nutzen. Gartner selbst sagt das Gegenteil: KI-taugliche Daten müssen für den jeweiligen Anwendungsfall repräsentativ sein. Datenbereitschaft lasse sich weder ein für alle Mal herstellen noch im Voraus für alle Daten aufbauen, sie sei ein fortlaufender Prozess (Gartner 2024). Interessant dabei: Für KI sind auch Fehler, Ausreißer und Sonderfälle wertvoll, denn genau die soll sie oft erkennen.
Der bessere Weg: vom Anwendungsfall zu den Daten.
- Aufgabe festlegen: Was genau soll die KI erledigen? Zum Beispiel „Rückfragen zu Lieferterminen beantworten“.
- KI fragen, was sie braucht: Beschreiben Sie einem Sprachmodell die Aufgabe und lassen Sie es auflisten, welche Informationen es für gute Antworten benötigen würde.
- Abgleichen: Welche dieser Daten haben Sie schon, wo liegen sie, wie aktuell sind sie?
- Klein starten: Mit den vorhandenen Daten einen Test fahren und schauen, wo die Antworten schwach sind.
- Gezielt nachbessern: Nur die Lücken schließen, die im Test auffallen.
Beispiel-Prompt für Schritt 2:
„Ich möchte, dass ein KI-Assistent Rückfragen unserer Kunden zu Lieferterminen beantwortet. Liste auf, welche Informationen und Datenquellen du dafür brauchst, sortiert nach ‚unverzichtbar‘, ‚hilfreich‘ und ‚verzichtbar‘. Nenne zu jeder Information, welche Fehler entstehen, wenn sie fehlt oder veraltet ist.“
So wird die KI selbst zum Werkzeug der Datenvorbereitung. Sie ersetzt nicht die Arbeit, aber sie zeigt, wo sie sich lohnt.
Kernpunkte:
- Ohne passende Daten scheitern KI-Projekte, das zeigen auch die Gartner-Zahlen.
- Passende Daten heißt: passend zum Anwendungsfall, nicht „alle Daten perfekt“.
- Lassen Sie die KI mitbestimmen, welche Daten sie für eine konkrete Aufgabe braucht.
Lektion 6: KI macht Fehler. Menschen auch.
Lernziel: Sie können erklären, warum KI halluziniert, wovon die Fehlerhäufigkeit abhängt und wie sich KI-Fehler zu menschlichen Fehlern verhalten.
Warum KI halluziniert. Eine Halluzination ist eine Antwort, die überzeugend klingt, aber falsch ist. Forschende von OpenAI und dem Georgia Institute of Technology erklären das so: Die üblichen Trainings- und Bewertungsverfahren belohnen Raten stärker als das Eingeständnis von Unsicherheit. Wie bei einer Prüfung, in der eine leere Antwort null Punkte bringt, lohnt sich für das Modell der Versuch (Kalai et al. 2025). Halluzinationen sind also kein mysteriöser Defekt, sondern eine Folge davon, wie Modelle gebaut und gemessen werden.
Fehler hängen vom Kontext und von der Kommunikation ab. Wie oft eine KI danebenliegt, ist keine feste Größe. Zwei Befunde zeigen das:
- Wo eine Information steht, zählt. Sprachmodelle nutzen Informationen am Anfang und am Ende eines langen Textes am besten. Steht das Entscheidende in der Mitte, sinkt die Trefferquote deutlich (Liu et al. 2023).
- Wie man fragt, zählt. Schon kleine Formatänderungen im Prompt, die den Inhalt nicht verändern, führten in einer Studie zu Leistungsunterschieden von bis zu 76 Prozentpunkten (Sclar et al. 2023).
Wer der KI klare Aufgaben, die richtigen Unterlagen und eine eindeutige Sprache gibt, bekommt deutlich verlässlichere Ergebnisse. Das ist bei Menschen übrigens genauso.
Menschen irren auch, und zwar mehr als gedacht.
- Der Psychologe Daniel Kahneman ließ in einer Versicherung identische Fälle von verschiedenen Underwritern bewerten. Die Führungskräfte erwarteten rund 10 Prozent Abweichung zwischen zwei Fachleuten. Tatsächlich lag die mittlere Abweichung bei 55 Prozent (Kahneman, Sibony, Sunstein 2021, „Noise“). Auch Menschen sind also „nicht deterministisch“: gleicher Fall, verschiedene Urteile.
- In der ambulanten Medizin in den USA erleben schätzungsweise 5 Prozent der Erwachsenen pro Jahr einen Diagnosefehler, rund 12 Millionen Menschen (Singh, Meyer, Thomas 2014, BMJ Quality & Safety).
Was daraus folgt. Der Vergleich soll KI-Fehler nicht kleinreden. KI-Fehler sind anders: Sie kommen oft sehr selbstsicher daher und wiederholen sich in großer Zahl, wenn niemand hinschaut. Aber die Frage „Macht die KI Fehler?“ ist die falsche. Die richtige lautet: „Wie hoch ist das Fehlerrisiko bei dieser Aufgabe, und wie fangen wir Fehler ab, egal ob Mensch oder Maschine sie macht?“
Bewährte Schutzmaßnahmen:
- Vier-Augen-Prinzip für alles, was nach außen geht oder Geld kostet
- Quellen verlangen: Lassen Sie sich zeigen, worauf eine Antwort beruht
- Unsicherheit erlauben: Sagen Sie der KI ausdrücklich, dass „Ich weiß es nicht“ eine gute Antwort ist
- Kontext liefern: Wichtiges an den Anfang, Unterlagen beifügen, Aufgabe eindeutig formulieren
- Risiko staffeln: Je höher der mögliche Schaden, desto niedriger die Autonomiestufe aus Lektion 3
Kernpunkte:
- Halluzinationen entstehen, weil Modelle für Raten belohnt werden, nicht aus Bosheit oder Zufall.
- Fehlerquoten hängen stark von Kontext und Formulierung ab.
- Auch Menschen urteilen bei gleichen Fällen erstaunlich unterschiedlich. Entscheidend ist ein Prüfprozess, der beide Fehlerarten abfängt.
Lektion 7: Der Klartext-Check. Sieben Aussagen, die Sie jetzt einordnen können
Lernziel: Sie können typische Fehlaussagen über KI erkennen und mit einem Satz richtigstellen.
Testen Sie Ihr Wissen. Lesen Sie jede Aussage, entscheiden Sie selbst, und lesen Sie dann die Einordnung.
1. „ChatGPT ist ein KI-Agent.“ Nicht ganz. ChatGPT ist zunächst ein Chatbot auf Basis generativer KI. Erst mit Werkzeugen und der Fähigkeit, mehrere Schritte selbst zu planen, wird daraus ein Agent, etwa im Agentenmodus (Lektion 1 und 4).
2. „Wir automatisieren den Kundenservice mit KI, dann läuft alles immer gleich.“ Wer generative KI einsetzt, autonomisiert. Die Antworten sind probabilistisch und nicht zwingend zweimal gleich. Das braucht Leitplanken und Prüfung (Lektion 2).
3. „Ein KI-Agent wird losgelassen und macht dann, was er will.“ Autonomie ist ein Regler. Rechte, Freigaben, Budget und Abbruchmöglichkeit legt der Mensch fest (Lektion 3).
4. „Die KI lernt mit jedem Gespräch dazu.“ Das Modell verändert sich im Gespräch nicht. Es kann sich Dinge merken, wenn eine Gedächtnisfunktion aktiv ist, aber es wird dadurch nicht klüger (Lektion 4).
5. „Mehr Agenten sind immer besser.“ Mehragentensysteme können deutlich besser sein, verbrauchen aber ein Vielfaches an Rechenleistung. Für einfache Aufgaben reicht oft ein einzelner, gut vorbereiteter Aufruf (Lektion 2 und 4).
6. „Bevor wir KI nutzen, müssen wir erst unsere Daten komplett aufräumen.“ Daten müssen zum Anwendungsfall passen, nicht perfekt sein. Lassen Sie die KI bestimmen, welche Daten sie für eine Aufgabe braucht (Lektion 5).
7. „KI halluziniert, also kann man ihr nicht trauen.“ KI macht Fehler, Menschen auch. Die Fehlerhäufigkeit hängt vom Kontext und von der Kommunikation ab. Vertrauen entsteht durch Prüfprozesse, nicht durch Fehlerfreiheit (Lektion 6).
Ihre Übung für diese Woche: Suchen Sie sich drei Beiträge über KI aus Ihrem Netzwerk. Prüfen Sie jeden mit drei Fragen: Welcher der vier Begriffe aus Lektion 1 ist eigentlich gemeint? Geht es um Automatisierung oder Autonomisierung? Welcher Autonomiegrad wird beschrieben? Sie werden überrascht sein, wie schnell sich Klarheit einstellt.
Kernpunkte:
- Begriffe sauber zu trennen ist die Grundlage für jede gute Entscheidung über KI.
- Die meisten Missverständnisse entstehen, weil Chatbot, Agent, Automatisierung und Autonomie vermischt werden.
- Mit den sieben Einordnungen können Sie jede KI-Diskussion versachlichen.
Zusammenfassung
KI ist ein Oberbegriff für vier ineinandersteckende Ebenen: maschinelles Lernen, Deep Learning, generative KI und agentische KI. Klassische Automatisierung arbeitet deterministisch nach festen Regeln. Generative und agentische KI handeln probabilistisch aus dem Kontext heraus, deshalb sprechen wir von Autonomisierung. Wie autonom ein Agent arbeitet, ist kein Naturgesetz, sondern eine Entscheidung, die der Mensch über Rechte, Freigaben und Kontrollpunkte trifft. Seit Ende 2022 hat sich KI von der reinen Textvorhersage über schrittweises Denken, Zugriff auf externe Daten und Werkzeuge, Planen mit Selbstkorrektur und Agententeams bis zu Systemen entwickelt, die von sich aus tätig werden. Mit jeder Stufe wandelt sich die Rolle des Menschen vom Bediener zum Aufsichtsrat, der Ziele und Leitplanken setzt. Damit das gelingt, braucht KI Daten, die zum Anwendungsfall passen, und die KI kann selbst helfen, diese zu bestimmen. Und schließlich: KI macht Fehler, Menschen auch. Gute Ergebnisse entstehen durch klaren Kontext, saubere Kommunikation und Prüfprozesse.
Quellen
- Anthropic (2024): Building effective agents. https://www.anthropic.com/engineering/building-effective-agents
- Anthropic (2024): Introducing the Model Context Protocol. https://www.anthropic.com/news/model-context-protocol
- Anthropic (2025): How we built our multi-agent research system. https://www.anthropic.com/engineering/multi-agent-research-system
- Bundesnetzagentur (2025): Definitionen der KI-Verordnung. https://www.bundesnetzagentur.de/DE/Fachthemen/Digitales/KI/6_Definitionen/artikel.html
- Europäische Union (2024): Verordnung (EU) 2024/1689 (KI-Verordnung), Art. 3 Nr. 1. https://eur-lex.europa.eu/eli/reg/2024/1689/oj
- Feng, K. J. K.; McDonald, D. W.; Zhang, A. X. (2025): Levels of Autonomy for AI Agents. Knight First Amendment Institute. https://arxiv.org/abs/2506.12469
- Gartner (2024): What Is AI-Ready Data? And How to Get Yours There. https://www.gartner.com/en/articles/ai-ready-data
- Gartner (2025): Lack of AI-Ready Data Puts AI Projects at Risk. https://www.gartner.com/en/newsroom/press-releases/2025-02-26-lack-of-ai-ready-data-puts-ai-projects-at-risk
- Kahneman, D.; Sibony, O.; Sunstein, C. R. (2021): Noise. A Flaw in Human Judgment. Besprechung: https://www.strategy-business.com/article/How-noisy-is-your-company
- Kalai, A. T.; Nachum, O.; Vempala, S. S.; Zhang, E. (2025): Why Language Models Hallucinate. https://arxiv.org/abs/2509.04664
- LeCun, Y.; Bengio, Y.; Hinton, G. (2015): Deep learning. Nature 521. https://www.nature.com/articles/nature14539
- Lewis, P. et al. (2020): Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. https://arxiv.org/abs/2005.11401
- Liu, N. F. et al. (2023): Lost in the Middle. How Language Models Use Long Contexts. https://arxiv.org/abs/2307.03172
- METR, Kwa, T. et al. (2025): Measuring AI Ability to Complete Long Tasks. https://arxiv.org/abs/2503.14499
- OpenAI (2022): Introducing ChatGPT. https://openai.com/index/chatgpt/
- OpenAI (2023): Function calling and other API updates. https://openai.com/index/function-calling-and-other-api-updates/
- OpenAI (2024): Learning to reason with LLMs. https://openai.com/index/learning-to-reason-with-llms/
- OpenAI (2024): Memory and new controls for ChatGPT. https://openai.com/index/memory-and-new-controls-for-chatgpt/
- OpenAI (2025): Introducing ChatGPT agent. https://openai.com/index/introducing-chatgpt-agent/
- OpenAI (2025): Introducing ChatGPT Pulse. https://openai.com/index/introducing-chatgpt-pulse/
- SAE International (2021): J3016. Taxonomy and Definitions for Terms Related to Driving Automation Systems. https://www.sae.org/standards/content/j3016_202104/
- Samuel, A. L. (1959): Some Studies in Machine Learning Using the Game of Checkers. IBM Journal of Research and Development 3(3). https://doi.org/10.1147/rd.33.0210
- Sclar, M. et al. (2023): Quantifying Language Models' Sensitivity to Spurious Features in Prompt Design. https://arxiv.org/abs/2310.11324
- Shinn, N. et al. (2023): Reflexion. Language Agents with Verbal Reinforcement Learning. https://arxiv.org/abs/2303.11366
- Singh, H.; Meyer, A. N. D.; Thomas, E. J. (2014): The frequency of diagnostic errors in outpatient care. BMJ Quality & Safety 23(9). https://qualitysafety.bmj.com/content/23/9/727
- Thinking Machines Lab (2025): Defeating Nondeterminism in LLM Inference. https://thinkingmachines.ai/blog/defeating-nondeterminism-in-llm-inference/
- Vaswani, A. et al. (2017): Attention Is All You Need. https://arxiv.org/abs/1706.03762
- Wei, J. et al. (2022): Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. https://arxiv.org/abs/2201.11903
- Yao, S. et al. (2022): ReAct. Synergizing Reasoning and Acting in Language Models. https://arxiv.org/abs/2210.03629