Aktuelle Sprachmodelle 2026: Landschaft, Modellwahl und das neue Modell Jev
Herausgegeben von der Tanagra Akademie · Zuletzt aktualisiert am
Alle Inhalte sind mit Hilfe von KI entstanden.
Im September 2026 ist in drei Wochen mehr passiert als früher in einem halben Jahr. Anthropic hat Claude Fable 5.1 veröffentlicht, Google Gemini 3.8 Flash, OpenAI GPT-6 Astra und kurz darauf die günstigeren Modelle GPT-6 Sol und Luna. Am selben Tag wie Sol und Luna brachte Anthropic Claude Opus 5.5 heraus, das sich in der wichtigsten unabhängigen Rangliste sofort an die Spitze setzte, obwohl...
Kurs als Podcast hören
Anna und Max besprechen die wichtigsten Inhalte dieses Kurses. Die Hörfassung ist ebenfalls mit Hilfe von KI entstanden.
Auf einen Blick
| Kategorie | Grundlagen |
|---|---|
| Niveau | Fortgeschritten |
| Dauer | 1 Std |
| Sprache | Deutsch |
| Zugang | frei zugänglich |
| Zuletzt aktualisiert |
Inhalt des Kurses
- Einleitung
- Lektion 1: Der Markt im Herbst 2026
- Lektion 2: Die geschlossenen Spitzenmodelle
- Lektion 3: Offene Modelle und europäische Anbieter
- Lektion 4: Die fünf großen Entwicklungen des Jahres
- Lektion 5: Jev, das Modell, das nicht spricht
- Lektion 6: Stärken nach Einsatzgebiet: Texte, Code, Bilder, Recherche, Sprache und Video
- Lektion 7: Welches Modell wofür?
- Lektion 8: Die Harness: Kontext, Werkzeuge und alles um das Modell herum
- Lektion 9: Aussichten, was als Nächstes kommt
- Gesamtzusammenfassung
- Quellenverzeichnis
Quellen und weiterführende Links
Worauf sich dieser Kurs stützt:
- Claude Docs 2026 (platform.claude.com)
- innFactory 2026 (innfactory.ai)
- innFactory 2026 (innfactory.ai)
- Wikipedia 2026 (en.wikipedia.org)
- xAI Release Notes 2026 (docs.x.ai)
- Wikipedia 2026 (en.wikipedia.org)
- TechCrunch 2026 (techcrunch.com)
- Anthropic 2026 (anthropic.com)
- OrcaRouter 2026 (orcarouter.ai)
- Yotta Labs 2026 (yottalabs.ai)
- VentureBeat 2026 (venturebeat.com)
- Claude Docs 2026 (platform.claude.com)
- Artificial Analysis 2026 (artificialanalysis.ai)
- OpenAI System Card 2026 (deploymentsafety.openai.com)
- TechCrunch 2026 (techcrunch.com)
- OfficeChai 2026 (officechai.com)
- The Decoder 2026 (the-decoder.com)
- Anthropic 2026 (anthropic.com)
- heise 2026 (heise.de)
- Codersera 2026 (codersera.com)
- VentureBeat 2026 (venturebeat.com)
- 24/7 Wall St. 2026 (247wallst.com)
- Devoriales 2026 (devoriales.com)
- MorphLLM 2026 (morphllm.com)
- CellCog 2026 (cellcog.ai)
Kursinhalt
Aktuelle Sprachmodelle 2026: Landschaft, Modellwahl und das neue Modell Jev
Einleitung
Im September 2026 ist in drei Wochen mehr passiert als früher in einem halben Jahr. Anthropic hat Claude Fable 5.1 veröffentlicht, Google Gemini 3.8 Flash, OpenAI GPT-6 Astra und kurz darauf die günstigeren Modelle GPT-6 Sol und Luna. Am selben Tag wie Sol und Luna brachte Anthropic Claude Opus 5.5 heraus, das sich in der wichtigsten unabhängigen Rangliste sofort an die Spitze setzte, obwohl es deutlich weniger kostet als die bisherigen Spitzenmodelle. Alibaba hat Qwen 4 angekündigt. Und dazwischen kam ein Modell von einem kleinen Start-up, über das plötzlich alle Entwickler sprachen: Jev, ein Modell, das keinen einzigen Satz schreibt.
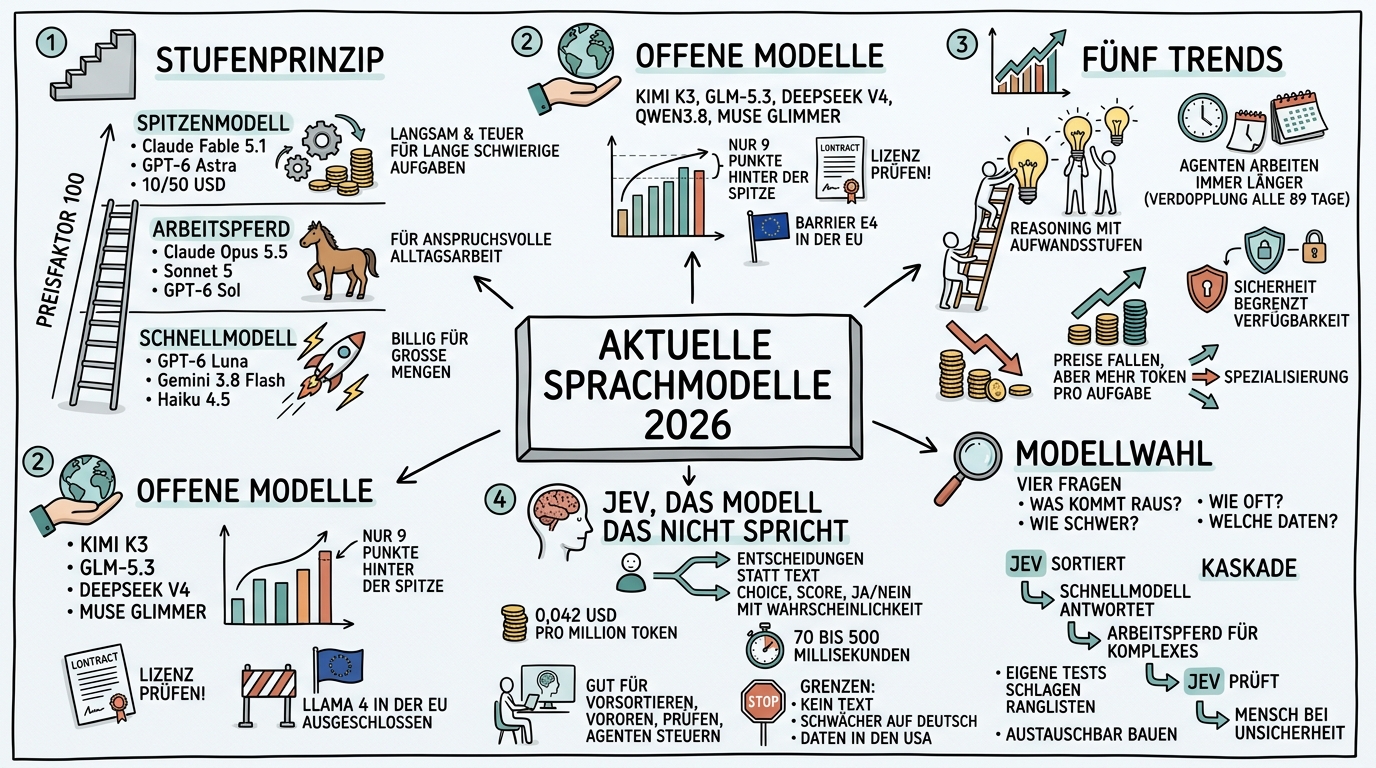
Dieser Kurs sortiert die Lage. Du lernst, welche Modelle es gerade gibt und wofür sie gebaut sind, welche Entwicklungen den Markt prägen und welches Modell in welchem Einsatzgebiet vorne liegt, von Texten über Bilder bis zur Recherche. Du lernst, wie du für eine Aufgabe das passende Modell wählst und warum die Umgebung um das Modell herum, die Harness, über Qualität und Kosten mitentscheidet. Zum Schluss geht es darum, was in den nächsten Monaten zu erwarten ist. Jev bekommt eine eigene Lektion, weil es nicht einfach ein weiteres Sprachmodell ist, sondern eine andere Idee davon, wie Software und KI zusammenarbeiten.
Stand aller Angaben: 23. September 2026. Preise und Modellnamen ändern sich in diesem Markt im Wochentakt. Die Denkwerkzeuge aus diesem Kurs bleiben länger gültig als jede einzelne Zahl.
Aufbau des Kurses:
- Der Markt im Herbst 2026: ein Überblick
- Die geschlossenen Spitzenmodelle: OpenAI, Anthropic, Google, xAI und Meta
- Offene Modelle und europäische Anbieter
- Die fünf großen Entwicklungen des Jahres
- Jev: das Modell, das nicht spricht
- Stärken nach Einsatzgebiet: Texte, Code, Bilder, Recherche, Sprache und Video
- Welches Modell wofür? Die Modellwahl in der Praxis
- Die Harness: Kontext, Werkzeuge und alles um das Modell herum
- Aussichten: was als Nächstes kommt
Lektion 1: Der Markt im Herbst 2026
Lernziel: Du kennst die wichtigsten Veröffentlichungen der letzten Wochen und verstehst, warum Anbieter ihre Modelle heute in Stufen anbieten.
Drei Wochen im September
Wer im August zuletzt auf den Markt geschaut hat, findet im September eine neue Landschaft vor:
| Datum | Ereignis |
|---|---|
| 1. September | Anthropic veröffentlicht Claude Fable 5.1 (Claude Docs 2026) |
| 2. September | Google macht Gemini 3.8 Flash allgemein verfügbar (innFactory 2026), Meta bringt Muse Spark 1.3 (innFactory 2026) |
| 3. und 4. September | OpenAI führt GPT-6 Astra ein, zuerst für ausgewählte Organisationen, am Folgetag allgemein (Wikipedia 2026) |
| September | xAI veröffentlicht Grok 4.7 (xAI Release Notes 2026) |
| 15. September | TypeSafe AI stellt Jev im Early Access vor (Wikipedia 2026) |
| 22. September | OpenAI veröffentlicht GPT-6 Sol und GPT-6 Luna (TechCrunch 2026), Anthropic veröffentlicht Claude Opus 5.5 (Anthropic 2026), Alibaba kündigt Qwen 4 an (OrcaRouter 2026) |
Das Stufenprinzip: Spitze, Arbeitspferd, Schnellmodell
Fast jeder große Anbieter bietet heute nicht ein Modell an, sondern eine Familie in drei bis vier Stufen. Das Muster ist überall gleich:
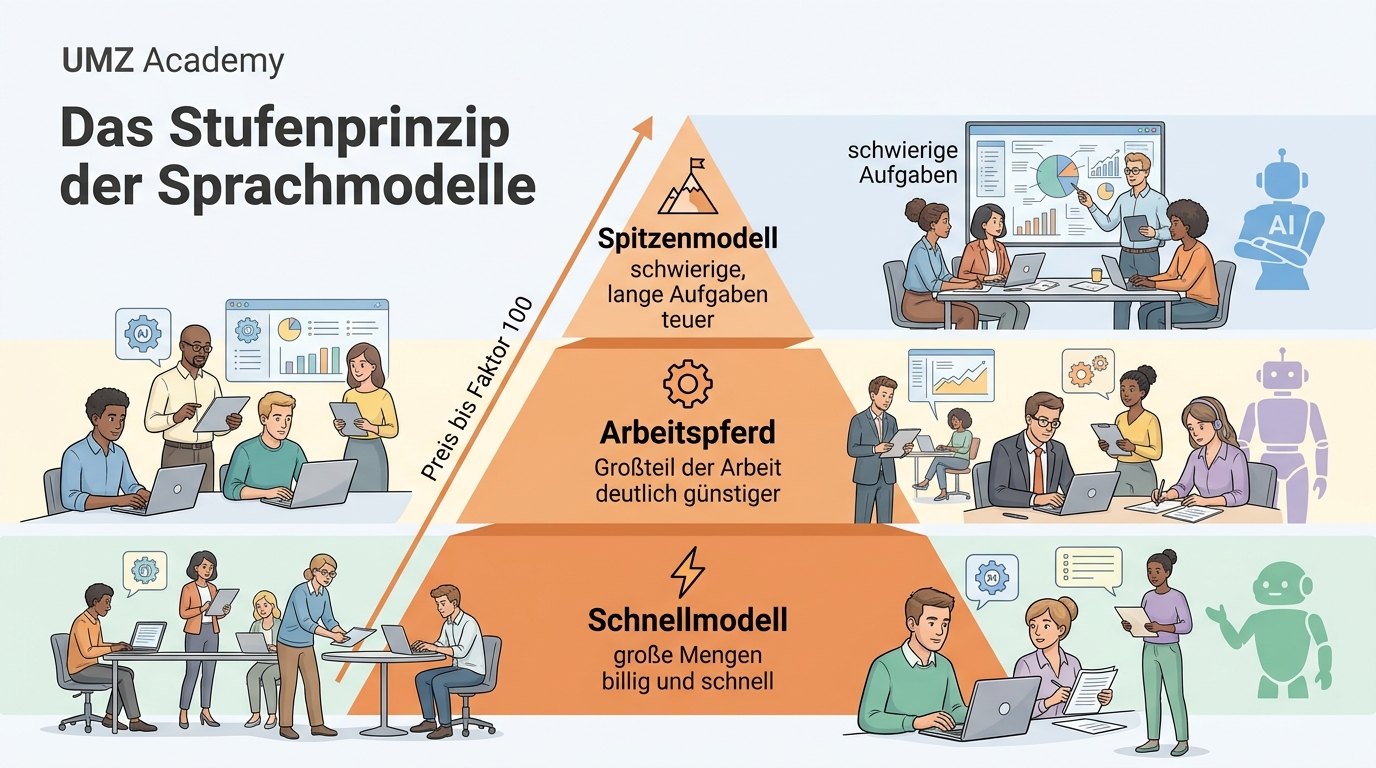
- Spitzenmodell: maximal leistungsfähig, langsam, teuer. Gedacht für schwierige, lange Aufgaben. Beispiele: Claude Fable 5.1, GPT-6 Astra.
- Arbeitspferd: das Modell für den Großteil der anspruchsvollen Arbeit, deutlich günstiger. Beispiele: Claude Opus 5.5 oder Sonnet 5, GPT-6 Sol.
- Schnellmodell: billig und schnell für große Mengen einfacher Aufgaben. Beispiele: GPT-6 Luna, Gemini 3.8 Flash, Claude Haiku 4.5.
Wie stark sich die Stufen im Preis unterscheiden, zeigt OpenAI: GPT-6 Astra kostet 10 US-Dollar pro Million Eingabe-Token (Yotta Labs 2026), GPT-6 Luna 0,10 US-Dollar (TechCrunch 2026, VentureBeat 2026). Das ist der Faktor 100 innerhalb derselben Modellgeneration.
Selbst die Anbieter raten davon ab, immer zum Spitzenmodell zu greifen. Anthropic empfiehlt in seiner Dokumentation, im Zweifel für die meisten Aufgaben mit Claude Opus 5.5 zu beginnen und Fable 5.1 nur dann einzusetzen, wenn Opus 5.5 auch bei höherem Aufwand nicht ausreicht (Claude Docs 2026).
Opus 5.5 zeigt zugleich, dass die Stufen sich nach dem Preis richten, nicht zwingend nach der Leistung: Es kostet weniger als die Hälfte von Fable 5.1, führt aber seit dem 22. September die Rangliste von Artificial Analysis an (Artificial Analysis 2026). Mehr dazu in Lektion 2.
Kurz erklärt: Token und Kontextfenster
Zwei Begriffe begegnen dir in diesem Kurs ständig:
- Token sind die Einheiten, in denen Sprachmodelle Text verarbeiten und abrechnen. Ein Token ist ungefähr ein Wortteil. Preise werden pro Million Token angegeben, getrennt nach Eingabe (was du dem Modell schickst) und Ausgabe (was es erzeugt).
- Kontextfenster ist die Textmenge, die ein Modell auf einmal berücksichtigen kann. Bei Claude entspricht eine Million Token etwa 555.000 Wörtern (Claude Docs 2026). Warum ein großes Kontextfenster nicht heißt, dass du es füllen solltest, zeigt Lektion 8.
Zusammenfassung:
- Im September 2026 haben alle großen Anbieter neue Modelle veröffentlicht, dazu kam mit Jev ein völlig neuer Modelltyp.
- Anbieter bieten Modellfamilien in Stufen an: Spitzenmodell, Arbeitspferd, Schnellmodell.
- Zwischen den Stufen einer Familie liegt bei OpenAI ein Preisfaktor von 100.
- Selbst Anthropic empfiehlt, nicht standardmäßig das teuerste Modell zu nehmen, sondern mit Opus 5.5 zu beginnen.
- Die Stufe sagt etwas über den Preis, nicht zwingend über die Leistung: Opus 5.5 liegt preislich in der Mitte und in der Rangliste vorn.
Reflexionsfrage: Welches Modell nutzt du heute für deine Arbeit, und weißt du, in welcher Stufe seiner Familie es steht?
Lektion 2: Die geschlossenen Spitzenmodelle
Lernziel: Du kennst die aktuellen Modelle der großen kommerziellen Anbieter, ihre Preise und ihre besonderen Stärken.
„Geschlossen“ heißt: Du nutzt das Modell über eine App oder eine Programmierschnittstelle (API) des Anbieters, die Modellgewichte selbst bekommst du nicht.
OpenAI: GPT-6 Astra, Sol und Luna
GPT-6 Astra ist das Spitzenmodell. Es verarbeitet bis zu 1,05 Millionen Token Eingabe und bis zu 128.000 Token Ausgabe, der Preis liegt bei 10 US-Dollar pro Million Eingabe-Token und 50 US-Dollar pro Million Ausgabe-Token (Yotta Labs 2026). OpenAI stuft Astra als erstes Modell auf der Stufe „Critical“ für Cybersicherheitsfähigkeiten in seinem Preparedness Framework ein (OpenAI System Card 2026). Die öffentliche Version lehnt deshalb bestimmte Anfragen im Bereich Cybersicherheit ab (Wikipedia 2026).
GPT-6 Sol zielt auf komplexe Arbeit wie Programmierung und kostet 2 US-Dollar pro Million Eingabe-Token und 10 US-Dollar pro Million Ausgabe-Token. GPT-6 Luna ist für einfache Aufgaben in großer Menge gedacht, etwa Zusammenfassungen und Informationsextraktion, und kostet 0,10 beziehungsweise 0,50 US-Dollar. Beide sind laut OpenAI halb so teuer wie ihre Vorgänger aus der Serie 5.6 (TechCrunch 2026). Luna steht auch Nutzern der kostenlosen ChatGPT-Version zur Verfügung (ebd.).
Anthropic: Claude Opus 5.5, Fable 5.1, Sonnet 5 und Haiku 4.5
Claude Opus 5.5 ist das neueste Modell von Anthropic und kam am 22. September 2026 heraus, nur zwei Monate nach seinem Vorgänger Opus 5 vom 24. Juli (TechCrunch 2026). Es ist das erste Modell der neuen Generation 5.5 und läuft über die Claude-App, die API sowie bei Amazon Web Services, Google Cloud und Microsoft Azure (Anthropic 2026).
Das Besondere ist das Verhältnis von Preis zu Leistung:
- Preis: 4 US-Dollar pro Million Eingabe-Token und 20 US-Dollar pro Million Ausgabe-Token, gegenüber 5 und 25 US-Dollar bei Opus 5. Das Lesen aus dem Zwischenspeicher (Cache) kostet 0,20 statt 0,50 US-Dollar (Anthropic 2026).
- Betriebskosten: Bei typischen Aufgaben soll Opus 5.5 rund 40 Prozent weniger kosten als Opus 5 und seine Antworten mehr als 30 Prozent schneller ausgeben (ebd.).
- Leistung laut Anthropic: Im Programmier-Benchmark Terminal-Bench 4.0 erreicht Opus 5.5 66,4 Prozent gegenüber 52,3 Prozent bei Opus 5, bei der Computerbedienung im Test OSWorld 2.0 81,8 statt 74,0 Prozent (ebd.).
- Unabhängige Messung: Artificial Analysis misst für Opus 5.5 auf höchster Aufwandsstufe 58 Punkte im Intelligenz-Index, den höchsten Wert, den das Institut bisher gemessen hat. Claude Fable 5.1 und GPT-6 Astra liegen bei je 53 Punkten (Artificial Analysis 2026, OfficeChai 2026).
- Schreibstil: Anthropic verspricht, dass Opus 5.5 die wichtigste Information an den Anfang stellt und weniger Fachjargon verwendet (TechCrunch 2026). Damit reagiert das Unternehmen auf Kritik am umständlichen „Claude-Stil“ früherer Modelle (The Decoder 2026).
- Technik: Kontextfenster von einer Million Token, bis zu 128.000 Token Ausgabe, Wissensstand Juni 2026. Die Aufwandsstufe steht standardmäßig auf „medium“ (Claude Docs 2026).
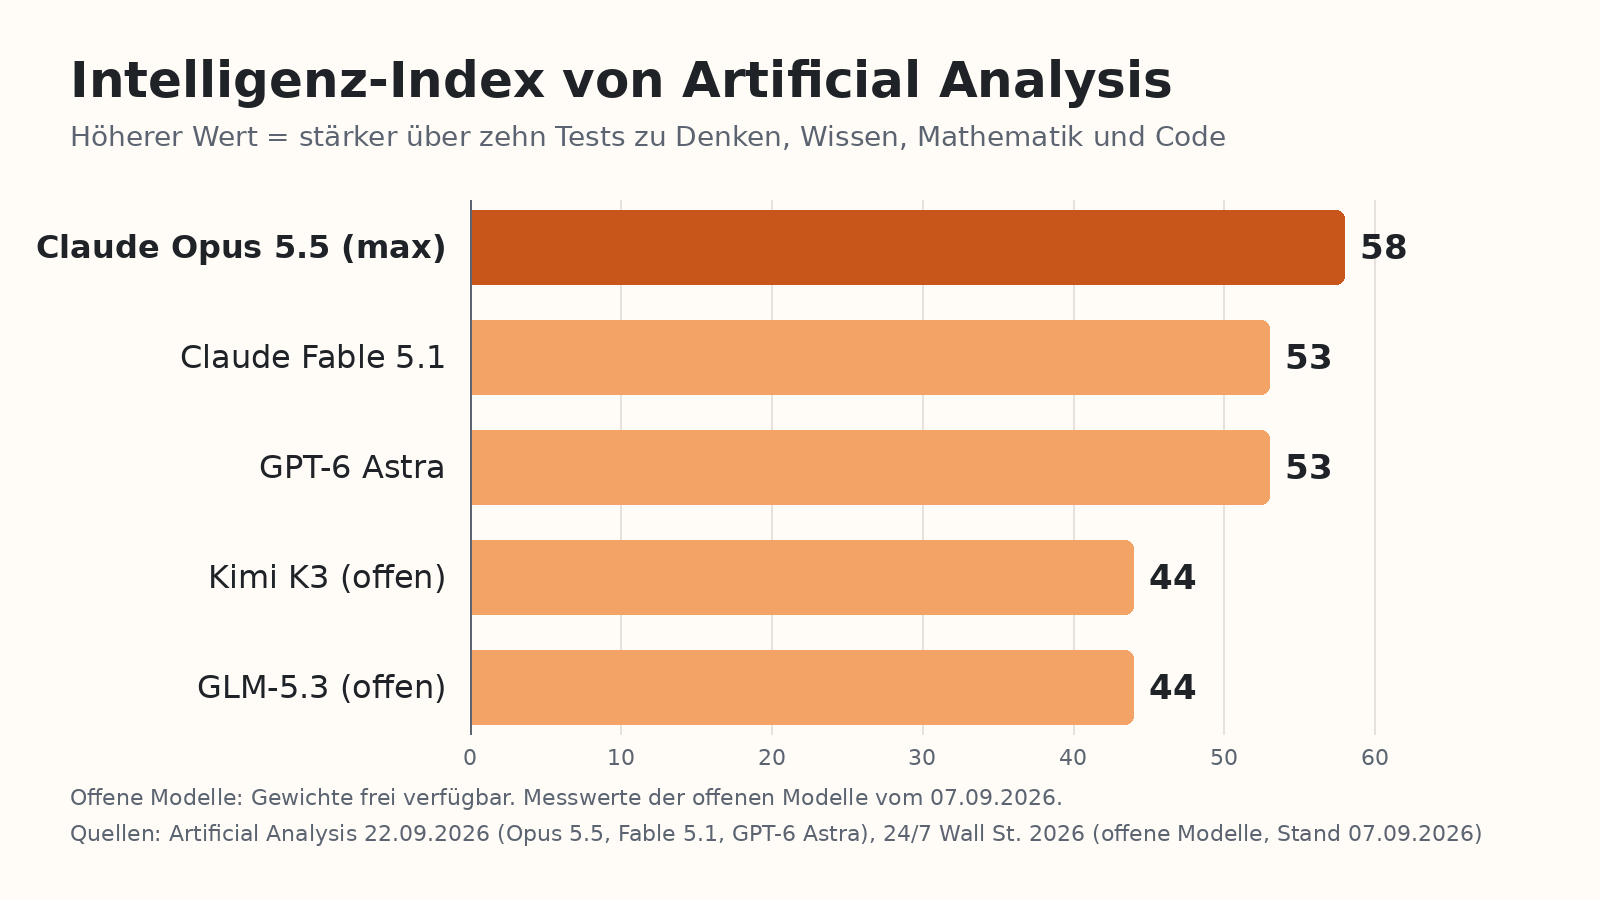
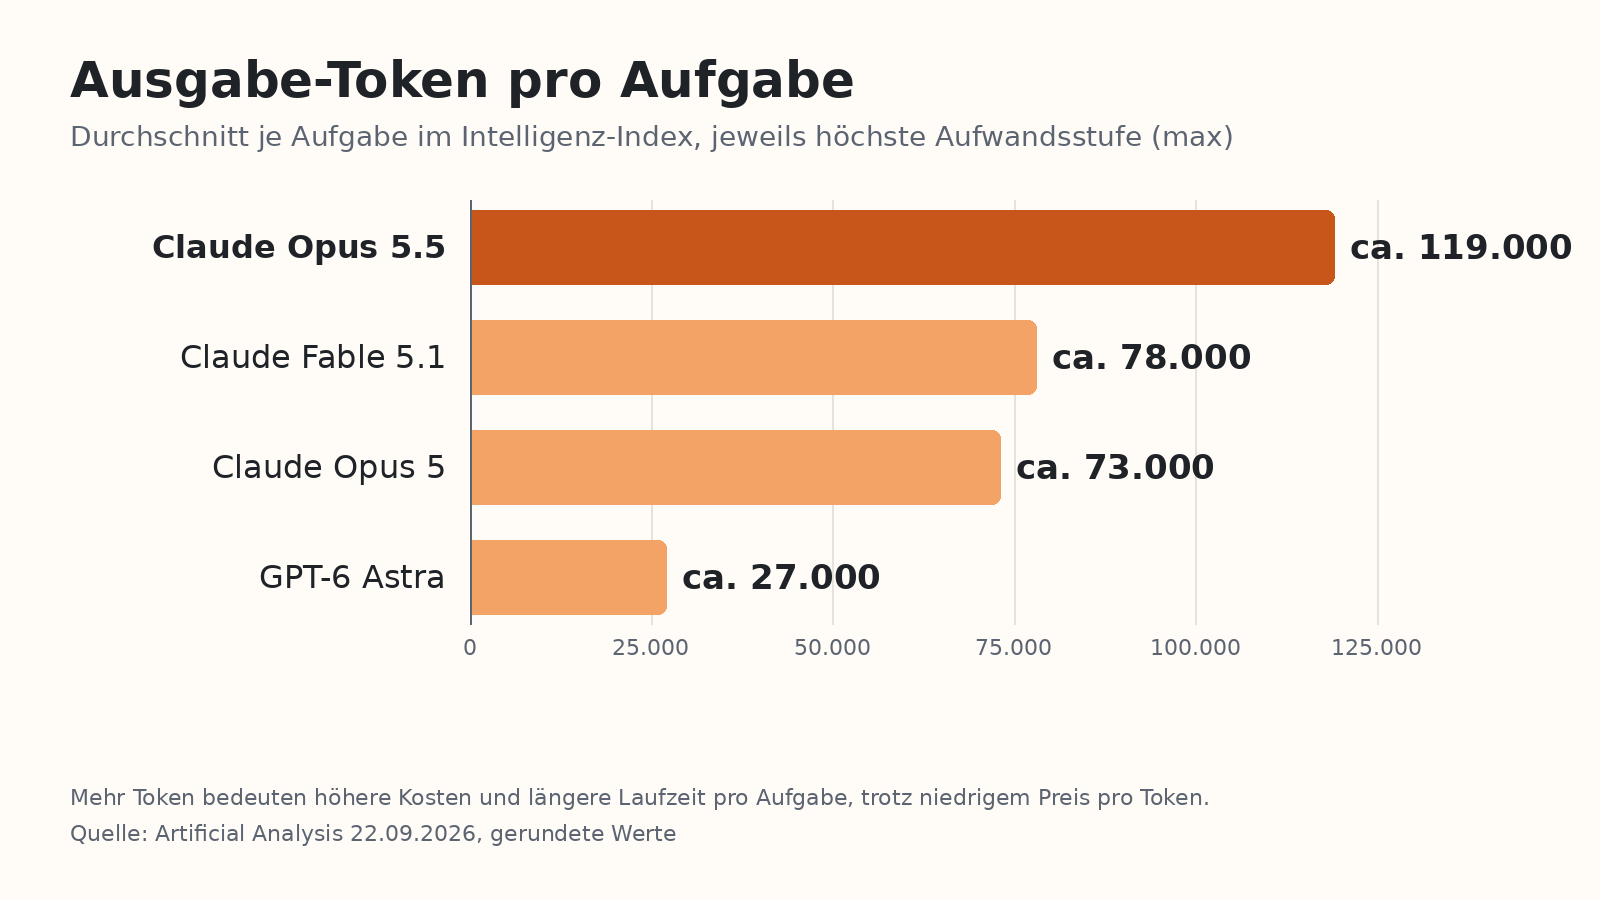
Der Haken: Auf höchster Aufwandsstufe verbraucht Opus 5.5 im Index von Artificial Analysis rund 119.000 Ausgabe-Token pro Aufgabe, GPT-6 Astra nur rund 27.000 (Artificial Analysis 2026). Der niedrige Preis pro Token wird also teilweise durch mehr Token aufgezehrt. Lektion 4 greift das auf.
Bei Cybersicherheit und Biologie ist Opus 5.5 laut Anthropic so leistungsfähig, dass dieselben Schutzmechanismen gelten wie bei Fable 5.1, etwa Sperren bei der Suche nach Sicherheitslücken (TechCrunch 2026).
Claude Fable 5.1 erschien am 1. September 2026, hat ein Kontextfenster von einer Million Token und kostet 10 US-Dollar Eingabe und 50 US-Dollar Ausgabe pro Million Token (Claude Docs 2026). Es ist für Aufgaben gebaut, die Stunden dauern und sich über viele Anwendungen erstrecken, zum Beispiel lange Programmier- und Rechercheaufträge (Anthropic 2026). Beim Benchmark Terminal-Bench-Science stieg die Leistung gegenüber dem Vorgänger von 24,7 auf 52,6 Prozent (heise 2026). Eine Variante mit denselben Fähigkeiten, Claude Mythos 5.1, gibt es nur auf Einladung im Rahmen von Project Glasswing (Claude Docs 2026).
Anthropic selbst empfiehlt Fable 5.1 inzwischen nur noch für besonders anspruchsvolles Denken und lange Agentenaufgaben oder wenn Opus 5.5 nicht ausreicht (Claude Docs 2026).
Günstiger sind Claude Sonnet 5 (2 und 10 US-Dollar) und Claude Haiku 4.5 (1 und 5 US-Dollar) (ebd.). Nachfolger beider Modelle, Sonnet 5.5 und Haiku 5.5, sollen in den kommenden Wochen erscheinen (TechCrunch 2026).
Google: Gemini 3.8 Flash und Gemini 3.1 Pro
Gemini 3.8 Flash ist seit dem 2. September 2026 allgemein verfügbar, verarbeitet eine Million Token und kostet bis Ende 2026 0,75 US-Dollar Eingabe und 3,75 US-Dollar Ausgabe pro Million Token. Ab dem 1. Januar 2027 verdoppelt sich der Preis (innFactory 2026). Für europäische Unternehmen wichtig: Gemini 3.8 Flash unterstützt EU-Datenresidenz (ebd.).
Beim größeren Pro-Modell hängt Google hinterher. Gemini 3.1 Pro ist seit Februar 2026 in der Vorschau, das für Juni angekündigte Gemini 3.5 Pro ist ohne neuen Termin verschoben (ebd.).
xAI: Grok 4.7
Grok 4.7 ist das aktuelle Spitzenmodell von xAI, mit 500.000 Token Kontext und einem Preis von 2 US-Dollar Eingabe und 6 US-Dollar Ausgabe pro Million Token bei Anfragen unter 200.000 Token (xAI Release Notes 2026). Der Vorgänger Grok 4.6 kam erst am 12. August 2026 (Codersera 2026). Das zeigt das Tempo: xAI veröffentlicht fast monatlich.
Meta: Muse Spark
Meta hat sich 2026 von seiner reinen Open-Source-Linie gelöst. Muse Spark, im April 2026 vorgestellt, ist Metas erstes proprietäres Modell (VentureBeat 2026). Die aktuelle Version Muse Spark 1.3 kostet 1,25 US-Dollar Eingabe und 4,25 US-Dollar Ausgabe pro Million Token (innFactory 2026).
Übersicht: Preise der geschlossenen Modelle
| Anbieter | Modell | Stufe | Eingabe / Ausgabe (USD pro Mio. Token) | Kontext |
|---|---|---|---|---|
| OpenAI | GPT-6 Astra | Spitze | 10 / 50 | 1,05 Mio. |
| Anthropic | Claude Fable 5.1 | Spitze | 10 / 50 | 1 Mio. |
| Anthropic | Claude Opus 5.5 | Arbeitspferd (Preis), Index-Spitze | 4 / 20 | 1 Mio. |
| OpenAI | GPT-6 Sol | Arbeitspferd | 2 / 10 | k. A. |
| Anthropic | Claude Sonnet 5 | Arbeitspferd | 2 / 10 | 1 Mio. |
| xAI | Grok 4.7 | Spitze | 2 / 6 | 500.000 |
| Meta | Muse Spark 1.3 | Spitze | 1,25 / 4,25 | k. A. |
| Anthropic | Claude Haiku 4.5 | Schnell | 1 / 5 | 200.000 |
| Gemini 3.8 Flash | Schnell | 0,75 / 3,75 (bis 31.12.2026) | 1 Mio. | |
| OpenAI | GPT-6 Luna | Schnell | 0,10 / 0,50 | k. A. |
Quellen: siehe Abschnitte oben. „k. A.“ bedeutet: in den geprüften Quellen nicht angegeben.
Zusammenfassung:
- Claude Opus 5.5 (seit 22. September) führt die Rangliste von Artificial Analysis mit 58 Punkten an und kostet mit 4 und 20 US-Dollar weniger als die Hälfte der bisherigen Spitzenmodelle.
- GPT-6 Astra und Claude Fable 5.1 bleiben die teuersten Modelle, beide zu 10 und 50 US-Dollar und mit je 53 Punkten.
- Opus 5.5 braucht auf höchster Aufwandsstufe allerdings viel mehr Token pro Aufgabe als GPT-6 Astra.
- GPT-6 Astra ist das erste Modell, das OpenAI bei Cyberfähigkeiten als „Critical“ einstuft.
- Google punktet bei Flash-Modellen mit Preis und EU-Datenresidenz, das Pro-Modell verspätet sich.
- xAI veröffentlicht fast monatlich, Meta hat mit Muse Spark erstmals ein geschlossenes Modell.
Praxistipp: Lies bei jedem Modell nicht nur den Preis, sondern auch die Empfehlung des Anbieters, wofür es gedacht ist. Anthropic und OpenAI sagen inzwischen sehr offen, wann ihr Spitzenmodell überdimensioniert ist.
Lektion 3: Offene Modelle und europäische Anbieter
Lernziel: Du verstehst, was offene Modelle leisten, wie groß ihr Abstand zur Spitze ist und worauf du bei Lizenz und Betrieb achten musst.
Was „offen“ bedeutet
Bei offenen Modellen (Open Weights) veröffentlicht der Anbieter die Modellgewichte. Du kannst das Modell herunterladen, auf eigenen Servern betreiben und anpassen. Die Daten verlassen dann dein Haus nicht. Wichtig: „offen“ heißt nicht automatisch „frei nutzbar“. Die Lizenz entscheidet, was du darfst.
Der Abstand zur Spitze: von 9 auf 14 Punkte
Artificial Analysis bewertet Modelle mit einem Intelligenz-Index. Am 7. September 2026 lagen die besten offenen Modelle, GLM-5.3 und Kimi K3, bei je 44 Punkten, Claude Fable 5.1 und GPT-6 Astra bei je 53 Punkten. Der Abstand betrug also 9 Punkte (24/7 Wall St. 2026).
Zwei Wochen später sieht es anders aus: Claude Opus 5.5 erreicht 58 Punkte (Artificial Analysis 2026). Solange kein offenes Modell nachzieht, liegt die Spitze damit 14 Punkte vor den besten offenen Modellen. Das zeigt, wie schnell sich solche Abstände verschieben. Die offenen Modelle bleiben stark genug für sehr viele Aufgaben, der Abstand ist aber keine feste Größe.
Die wichtigsten offenen Modelle
Kimi K3 (Moonshot AI, China): Mit 2,8 Billionen Parametern das größte offene Modell, das bisher veröffentlicht wurde. Die Gewichte stehen seit dem 27. Juli 2026 auf Hugging Face (Devoriales 2026).
DeepSeek V4 (China): Unter der sehr freizügigen MIT-Lizenz veröffentlicht, in zwei Größen: V4 Pro mit 1,6 Billionen Parametern, von denen 49 Milliarden pro Token aktiv sind, und V4 Flash mit 284 Milliarden Parametern, davon 13 Milliarden aktiv (MorphLLM 2026). Seit dem 31. August 2026 gibt es auch eine offene Variante, die Bilder versteht (CellCog 2026).
Qwen3.8 (Alibaba, China): Qwen3.8-Max ist seit dem 3. August 2026 verfügbar, kostet über die API 2 und 6 US-Dollar pro Million Token, verarbeitet eine Million Token und hat veröffentlichte Gewichte (OrcaRouter 2026).
Muse Glimmer (Meta, USA): Ein Modell mit rund 30 Milliarden Parametern, seit dem 10. August 2026 unter der Apache-2.0-Lizenz offen. Es läuft auf Grafikkarten für Endverbraucher mit 18 bis 20 GB Speicher (in 4-Bit-Quantisierung) (innFactory 2026).
Warum die Parameterzahl täuscht: Mixture of Experts
Die Riesenzahlen wie 1,6 oder 2,8 Billionen Parameter klingen, als bräuchte man ein Rechenzentrum. Das stimmt für das Laden des Modells, nicht aber für jede einzelne Berechnung. Die meisten großen Modelle sind heute nach dem Prinzip Mixture of Experts (MoE) gebaut: Für jedes Token wird nur ein kleiner Teil des Netzes aktiv. Bei DeepSeek V4 Pro sind das 49 von 1.600 Milliarden Parametern (MorphLLM 2026). Das macht die Modelle schneller und günstiger im Betrieb. Den Speicher für das ganze Modell brauchst du trotzdem.
Für die Praxis heißt das: Die großen offenen Modelle wie Kimi K3 oder DeepSeek V4 Pro betreiben Unternehmen auf eigenen GPU-Servern oder bei einem Hoster. Auf einem einzelnen Arbeitsplatzrechner laufen Modelle in der Größe von Muse Glimmer.
Achtung Lizenz: der Fall Llama 4
Metas ältere Llama-4-Modelle sind technisch stark, aber ihre Community-Lizenz schließt Organisationen in der EU aus (innFactory 2026). Für Unternehmen im deutschsprachigen Raum ist deshalb Muse Glimmer die Meta-Option ohne territoriale Einschränkung (ebd.). Die Lehre daraus: Prüfe vor jedem Einsatz eines offenen Modells die Lizenz, nicht nur die Benchmarks.
Europäische Anbieter
Mistral (Frankreich) ist der wichtigste europäische Modellanbieter. Die aktuellen Modelle sind Mistral Medium 3.5 vom 29. April 2026 und Mistral Small 4 vom 16. März 2026 (AI Release Tracker 2026). Eine neue, größere offene Modellfamilie ist seit Juli 2026 im Early Access bei ausgewählten Partnern. Name, Benchmarks und Veröffentlichungstermin sind noch nicht bekannt (Digital Applied 2026).
Aleph Alpha (Deutschland) gibt es als eigenständigen Anbieter nicht mehr. Die am 24. April 2026 angekündigte „transatlantische Fusion“ mit dem kanadischen Anbieter Cohere ist de facto eine Übernahme durch Cohere (ZEIT 2026).
Zusammenfassung:
- Die besten offenen Modelle lagen im Index von Artificial Analysis Anfang September 9 Punkte hinter der Spitze, seit Opus 5.5 sind es 14 Punkte.
- Die stärksten offenen Modelle kommen aus China: Kimi K3, GLM-5.3, DeepSeek V4, Qwen3.8.
- Mixture of Experts macht große Modelle im Betrieb effizient, den vollen Speicher brauchen sie trotzdem.
- Lizenzen entscheiden: Llama 4 ist für EU-Organisationen ausgeschlossen, Muse Glimmer (Apache 2.0) nicht.
- Europa ist bei den Modellanbietern dünn besetzt: Mistral ist der wichtigste, Aleph Alpha gehört jetzt zu Cohere.
Reflexionsfrage: Welche Daten in deinem Unternehmen dürften unter keinen Umständen an einen US- oder chinesischen Cloud-Dienst gehen? Für genau diese Daten sind selbst betriebene offene Modelle interessant.
Lektion 4: Die fünf großen Entwicklungen des Jahres
Lernziel: Du erkennst die Entwicklungen, die den Markt 2026 prägen, und kannst neue Modellankündigungen daran einordnen.
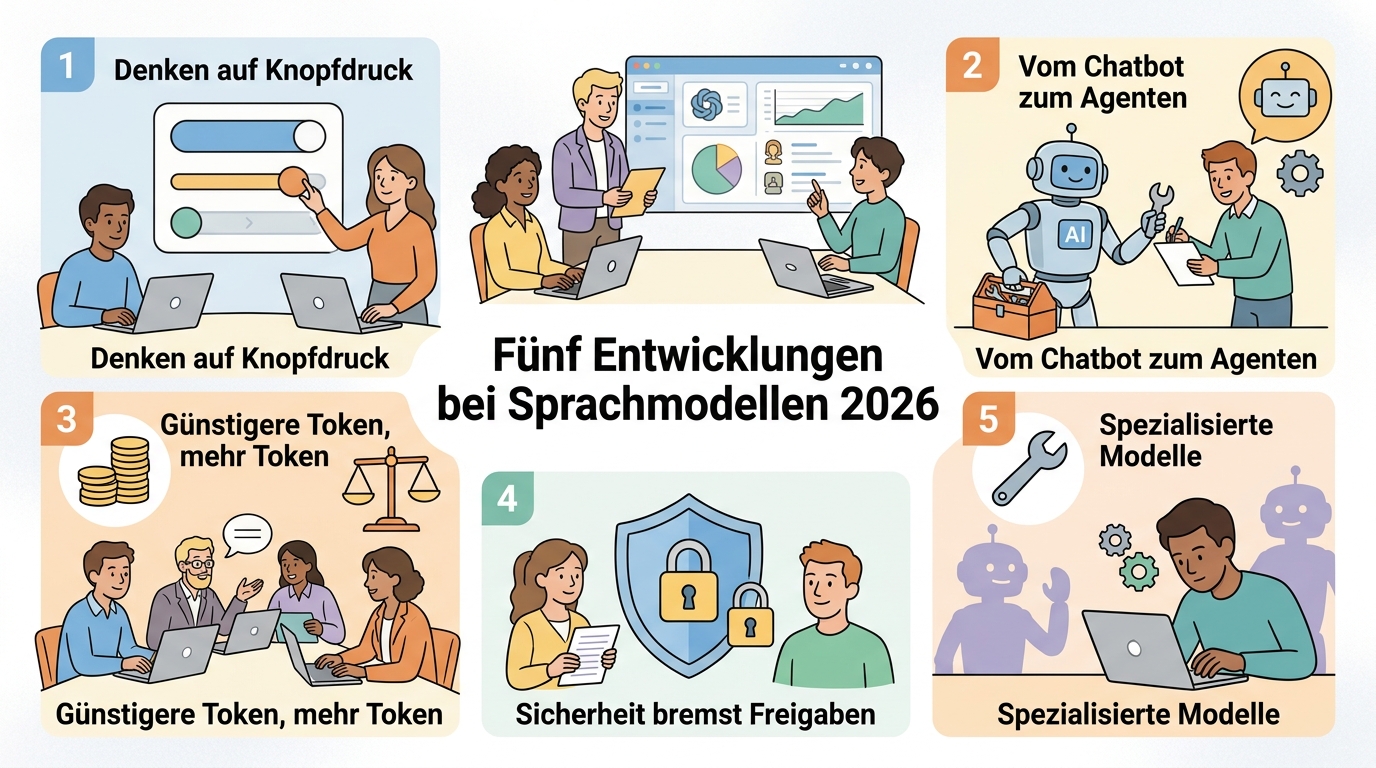
1. Denken auf Knopfdruck: Reasoning und Aufwandsstufen
Moderne Modelle „denken“ vor der Antwort, und du kannst steuern, wie viel. Bei Claude Fable 5.1 ist dieses adaptive Denken immer eingeschaltet, die Tiefe regelt ein Aufwandsparameter (Effort), der standardmäßig auf „high“ steht (Claude Docs 2026). Grok 4.6 hat eine zusätzliche Stufe „xhigh“ bekommen (Codersera 2026). Claude Opus 5.5 kennt fünf Stufen von „low“ bis „max“ (Anthropic 2026). Für dich heißt das: Dasselbe Modell kann schnell und günstig oder langsam und gründlich arbeiten. Die Aufwandsstufe ist ein zweiter Regler neben der Modellwahl.
2. Vom Chatbot zum Agenten
Die Spitzenmodelle werden vor allem daran gemessen, wie lange und selbstständig sie arbeiten können. Das Forschungsinstitut METR misst, wie lange Aufgaben dauern dürfen, die KI-Agenten zuverlässig lösen. Diese Zeitspanne hat sich seit 2024 etwa alle 89 Tage verdoppelt, über den gesamten Messzeitraum etwa alle 196 Tage (METR 2026). OpenAI bewirbt GPT-6 Astra entsprechend mit Computernutzung, Browsing und Softwareentwicklung (OpenAI 2026), Anthropic Claude Fable 5.1 mit Aufgaben, die Stunden dauern (Anthropic 2026).
3. Preisverfall, aber mehr Token
Der Preis für ein bestimmtes Leistungsniveau fällt dramatisch. Epoch AI hat gemessen, dass er je nach Aufgabe um das 9-Fache bis 900-Fache pro Jahr sinkt. GPT-4-Leistung bei Wissenschaftsfragen auf Doktoratsniveau wurde pro Jahr etwa 40-mal billiger (Epoch AI 2025). OpenAI hat die Preise mit Sol und Luna gerade halbiert (TechCrunch 2026).
Die Kehrseite: Neue Modelle erzeugen oft mehr Token pro Aufgabe. Claude Fable 5.1 produziert etwa 1,7-mal so viele Ausgabe-Token wie sein Vorgänger (heise 2026), Gemini 3.8 Flash rund 30 Prozent mehr als Gemini 3.7 Flash (innFactory 2026). Am deutlichsten zeigt es Claude Opus 5.5: Auf höchster Aufwandsstufe braucht es für eine Aufgabe im Index von Artificial Analysis rund 1,6-mal so viele Ausgabe-Token wie sein Vorgänger und gut viermal so viele wie GPT-6 Astra (Artificial Analysis 2026). Ein gleicher Preis pro Token heißt also nicht gleiche Kosten pro Aufgabe.
4. Sicherheit wird zum Verfügbarkeitsfaktor
Zum ersten Mal halten Anbieter Fähigkeiten ihrer Modelle bewusst zurück. OpenAI hat GPT-6 Astra nach Vorfällen mit unerlaubten Cyberangriffen durch OpenAI-Agenten im Juli 2026 verzögert und die öffentliche Version eingeschränkt (Wikipedia 2026). Anthropic bietet die Variante mit lockereren Cyber-Schutzmechanismen, Mythos 5.1, nur verifizierten Nutzern an (heise 2026). Für das neue Opus 5.5 gelten dieselben Schutzmechanismen wie für Fable 5.1 (TechCrunch 2026). Für Unternehmen bedeutet das: Nicht jede beworbene Fähigkeit steht jedem Kunden zur Verfügung.
5. Spezialisierung statt ein Modell für alles
Neben den großen Allroundern entstehen Modelle, die eine Sache sehr gut und sehr billig können. Das deutlichste Beispiel ist Jev, das gar keinen Text schreibt, sondern nur Entscheidungen trifft. Dazu mehr in Lektion 5.
Zusammenfassung:
- Reasoning ist Standard, die Aufwandsstufe ist neben der Modellwahl ein zweiter Regler für Qualität und Kosten.
- Die Aufgabendauer, die KI-Agenten schaffen, verdoppelt sich laut METR seit 2024 etwa alle 89 Tage.
- Preise pro Leistungsniveau fallen stark, neue Modelle verbrauchen aber oft mehr Token pro Aufgabe.
- Sicherheitsbedenken führen dazu, dass Anbieter Fähigkeiten zurückhalten oder nur ausgewählten Kunden geben.
- Spezialisierte Modelle ergänzen die Allrounder.
Praxistipp: Wenn du Modelle vergleichst, rechne mit Kosten pro erledigter Aufgabe, nicht mit dem Preis pro Token. Lass dieselbe Aufgabe zehnmal laufen und schau auf die Rechnung.
Lektion 5: Jev, das Modell, das nicht spricht
Lernziel: Du verstehst, was Jev ist, wie es sich von einem Sprachmodell unterscheidet, wofür es sich eignet und wie du Herstellerversprechen dazu prüfst.
Wer steckt dahinter?
Jev stammt von TypeSafe AI, einem 2024 gegründeten Start-up aus San Francisco. Mitgründer und Chef ist Diogo Almeida, der rund vier Jahre bei OpenAI an RLHF, InstructGPT, ChatGPT und GPT-4 gearbeitet hat. Das Modell kam am 15. September 2026 in einen begrenzten Early Access, zusammen mit einer Seed-Finanzierung von 40 Millionen US-Dollar unter Führung von DCVC (Wikipedia 2026). Seit dem 21. September gibt es keine Warteliste mehr, der Einstieg beginnt mit 5 US-Dollar Guthaben (NDTV Profit 2026).
Der Name ist Programm: Er verweist auf den Ökonomen William Stanley Jevons und das nach ihm benannte Paradoxon, nach dem Effizienz den Verbrauch einer Ressource steigert, statt ihn zu senken (Wikipedia 2026). TypeSafe erwartet also, dass sehr billige KI-Entscheidungen zu sehr viel mehr KI-Einsatz führen.
Die Idee: Entscheidungen statt Texte
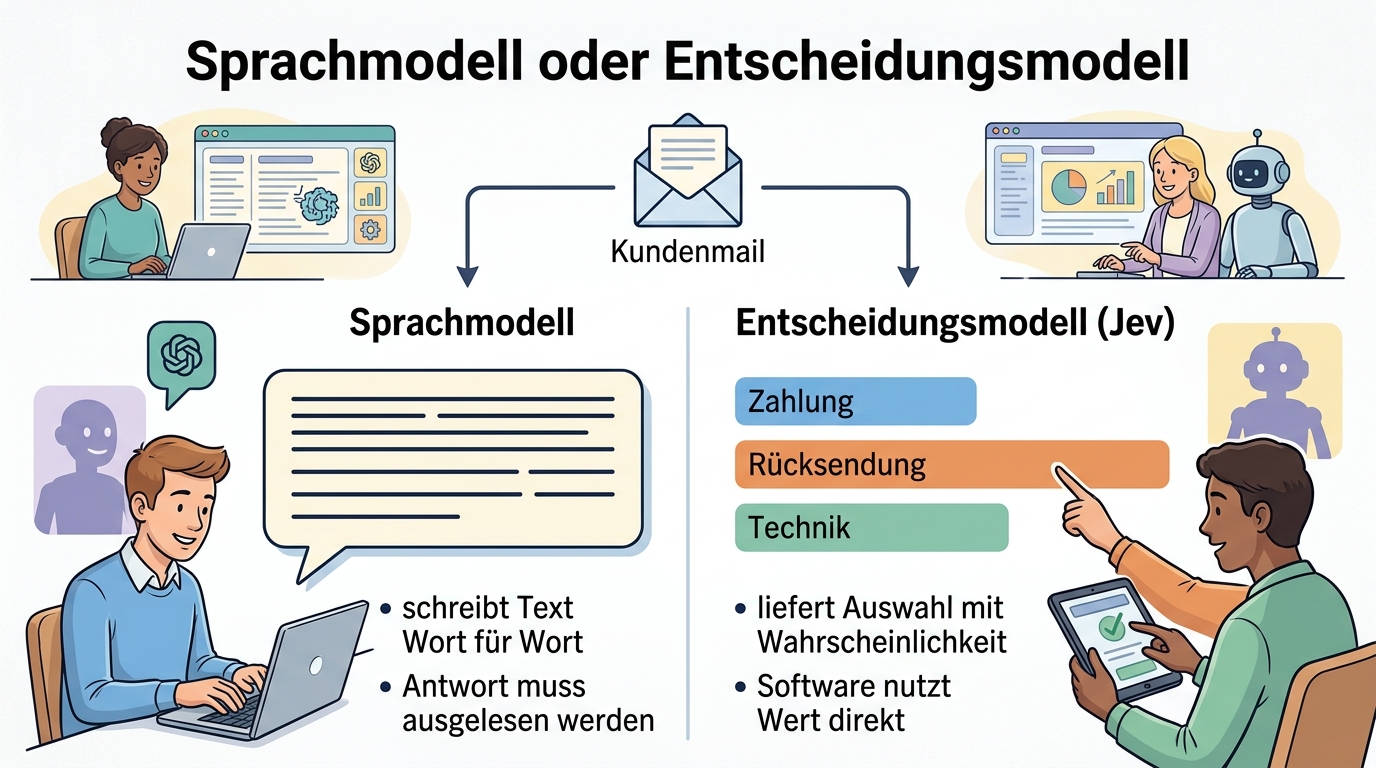
Ein Sprachmodell schreibt eine Antwort Wort für Wort. Wenn eine Software nur wissen will „Ist das eine Reklamation, ja oder nein?“, muss sie diese Textantwort anschließend wieder auslesen. Das ist langsam, teuer und fehleranfällig, etwa wenn das Modell ein falsches Format liefert.
Jev dreht das um. Es liefert keinen Text, sondern typisierte Werte zusammen mit Wahrscheinlichkeiten und Konfidenzwerten, die eine Software direkt weiterverarbeiten kann (Wikipedia 2026).
Es gibt drei Fragetypen (Wikipedia 2026):
| Fragetyp | Was Jev liefert | Beispiel |
|---|---|---|
| Choice | Auswahl aus festgelegten Optionen mit Wahrscheinlichkeit pro Option | Gehört die Kundenmail zu „Zahlung“, „Rücksendung“ oder „Technik“? |
| Score | Einordnung auf einer geordneten Skala | Wie dringend ist dieser Vorgang: niedrig, mittel, hoch? |
| Noul | Wahrscheinlichkeit zwischen 0 und 1 für eine Ja/Nein-Aussage | „Diese Antwort enthält persönliche Daten“: stimmt das? |
TypeSafe nennt das ein „System One Model“, angelehnt an Daniel Kahnemans Unterscheidung zwischen schnellem, intuitivem Urteilen (System 1) und langsamem, bewusstem Nachdenken (System 2). Jev übernimmt das schnelle Urteil, Sprachmodelle bleiben für das gründliche Nachdenken zuständig (innFactory 2026). Alle Fragen einer Anfrage beantwortet Jev parallel in einem Durchgang (ebd.).
Technisch ist Jev weiterhin ein Transformer-Modell. Trainiert wurde es ausschließlich mit synthetischen Daten und einem Verfahren namens „Reinforcement Learning for Calibrated Decisions“ (RLCD) (Wikipedia 2026). Ziel ist, dass die angegebenen Wahrscheinlichkeiten zu den tatsächlichen Trefferquoten passen (heise 2026). Wenn Jev „80 Prozent“ sagt, soll es in acht von zehn Fällen auch stimmen. Genau das braucht man, um automatisch zu entscheiden und nur unsichere Fälle an Menschen weiterzugeben.
Preis und Tempo
Jev kostet 0,042 US-Dollar pro Million Eingabe-Token, die Ausgabe ist kostenlos (the-decoder 2026). Die Antwortzeit liegt laut Hersteller zwischen 70 und 500 Millisekunden (heise 2026). TypeSafe gibt an, Jev sei 40- bis 200-mal schneller und 40- bis 400-mal günstiger als Spitzenmodelle, mit Spitzenwerten von 193,6-fach und 444,6-fach (Wikipedia 2026).
Rechenbeispiel: Ein Kundenservice sortiert eine Million Anfragen pro Monat vor, jede mit 500 Token Eingabe. Das sind 500 Millionen Token.
| Modell | Rechnung | Kosten pro Monat |
|---|---|---|
| Jev | 500 Mio. × 0,042 USD, Ausgabe kostenlos | 21 USD |
| GPT-6 Luna | 500 Mio. × 0,10 USD Eingabe plus 50 Mio. Ausgabe-Token × 0,50 USD | 75 USD |
| GPT-6 Sol | 500 Mio. × 2 USD Eingabe plus 50 Mio. Ausgabe-Token × 10 USD | 1.500 USD |
Annahme für die Sprachmodelle: 50 Ausgabe-Token pro Anfrage, ohne Denk-Token. Das Beispiel zeigt zweierlei. Gegenüber einem Arbeitspferd wie Sol ist der Unterschied gewaltig. Gegenüber einem Schnellmodell wie Luna schrumpft er auf etwa das Dreieinhalbfache. Die großen Faktoren aus der Werbung beziehen sich auf den Vergleich mit Spitzenmodellen.
Wie Jev ankam
Innerhalb von 36 Stunden nach dem Start registrierten sich 140.000 Entwickler, und bis zum 18. September hatten Vercel, Cloudflare, LangChain und Langfuse Jev eingebunden (BornCity 2026).
Wofür Jev sich eignet
Die Einsatzfälle, die Hersteller und Fachpresse nennen, haben eines gemeinsam: viele kleine Entscheidungen im Hintergrund (the-decoder 2026).
- Anfragen vorsortieren: Kundenmails an das richtige Team leiten, bevor ein teures Sprachmodell eine Antwort schreibt (heise 2026).
- Agenten steuern: entscheiden, welches Werkzeug ein KI-Agent als Nächstes aufruft (ebd.).
- Ausgaben prüfen: die Antwort eines KI-Assistenten vor dem Versand kontrollieren (the-decoder 2026).
- Große Dokumentmengen klassifizieren (innFactory 2026).
Was Jev nicht kann
- Keine Texte, keine Begründungen, keine Bilder oder Audio, kein mehrstufiges Denken (innFactory 2026). Das ist gewollt, heißt aber auch: Jev erklärt nicht, warum es sich so entschieden hat. Das wirft Fragen der Nachvollziehbarkeit auf (heise 2026).
- Keine Garantie für richtige Entscheidungen. Jev kann keine Antwort außerhalb der vorgegebenen Optionen erfinden. Innerhalb der Optionen kann es aber falsch wählen (the-decoder 2026).
- Schwächer bei nicht englischen Inhalten. Das ist für deutschsprachige Anwendungen besonders relevant (innFactory 2026).
- Datenstandort USA. Der Dienst läuft an der US-Westküste, EU-Unternehmen müssen die Datenresidenz prüfen (ebd.).
- Bekannte Schwächen der Version 1.13: wörtliches Lesen, Fehler bei Zahlen und Datumsvergleichen, Ablenkung durch viel irrelevanten Kontext und Anfälligkeit für manipulierte Eingaben (Wavect 2026).
Herstellerzahlen richtig lesen
Die Benchmarks zu Jev stammen vom Modellteam des Herstellers selbst, und TypeSafe räumt ein, dass sie eher das obere Ende darstellen (Wikipedia 2026). Eine unabhängige Prüfung gibt es bisher nicht. Wavect empfiehlt deshalb, nicht den Preis pro Aufruf zu messen, sondern den Preis pro akzeptierter Entscheidung, also inklusive Wiederholungen, Rückfallebenen und menschlicher Nachprüfung (Wavect 2026). Für den Produktiveinsatz rät Wavect (ebd.):
- Modellversion fest einstellen, nicht automatisch die neueste nutzen.
- Schwellenwerte mit eigenen Daten kalibrieren.
- Im Schattenbetrieb starten: Jev parallel zum bisherigen Verfahren laufen lassen und vergleichen.
- Eine regelbasierte Rückfallebene behalten.
- Jede neue Version erneut prüfen.
Und: Folgenreiche Aktionen wie Finanztransaktionen sollten nie allein an Jev hängen (ebd.).
Zusammenfassung:
- Jev von TypeSafe AI liefert keine Texte, sondern typisierte Entscheidungen mit kalibrierten Wahrscheinlichkeiten.
- Drei Fragetypen: Auswahl (Choice), Skala (Score), Ja/Nein-Wahrscheinlichkeit (Noul).
- 0,042 US-Dollar pro Million Eingabe-Token, Ausgabe kostenlos, 70 bis 500 Millisekunden laut Hersteller.
- Stark für Vorsortieren, Agentensteuerung und Prüfen, ungeeignet für Texte, Begründungen und mehrstufiges Denken.
- Schwächer auf Deutsch, Datenstandort USA, Herstellerbenchmarks noch nicht unabhängig bestätigt.
Reflexionsfrage: Wo in deinen Abläufen trifft heute ein Mensch oder ein teures Sprachmodell hundertfach am Tag dieselbe kleine Ja/Nein-Entscheidung?
Lektion 6: Stärken nach Einsatzgebiet: Texte, Code, Bilder, Recherche, Sprache und Video
Lernziel: Du weißt, welche Art von Modell du für Texte, Programmierung, Bilder, Recherche, Sprachausgabe und Video brauchst, wer in den jeweiligen Ranglisten vorne liegt und wie du diese Ranglisten richtig liest.
Ja, es gibt eine Einteilung nach Einsatzgebiet
Die bekannteste Einteilung liefert die Plattform Arena (früher LMArena). Dort vergleichen Menschen blind zwei Ergebnisse und wählen das bessere, ohne zu wissen, welches Modell dahintersteht. Arena führt getrennte Ranglisten, unter anderem für Text, Webentwicklung, Bildverstehen, Dokumente, Bilderzeugung, Bildbearbeitung, Websuche und Video (Arena 2026). Für Sprachausgabe führt Artificial Analysis eine eigene Rangliste nach demselben Prinzip (Artificial Analysis 2026).
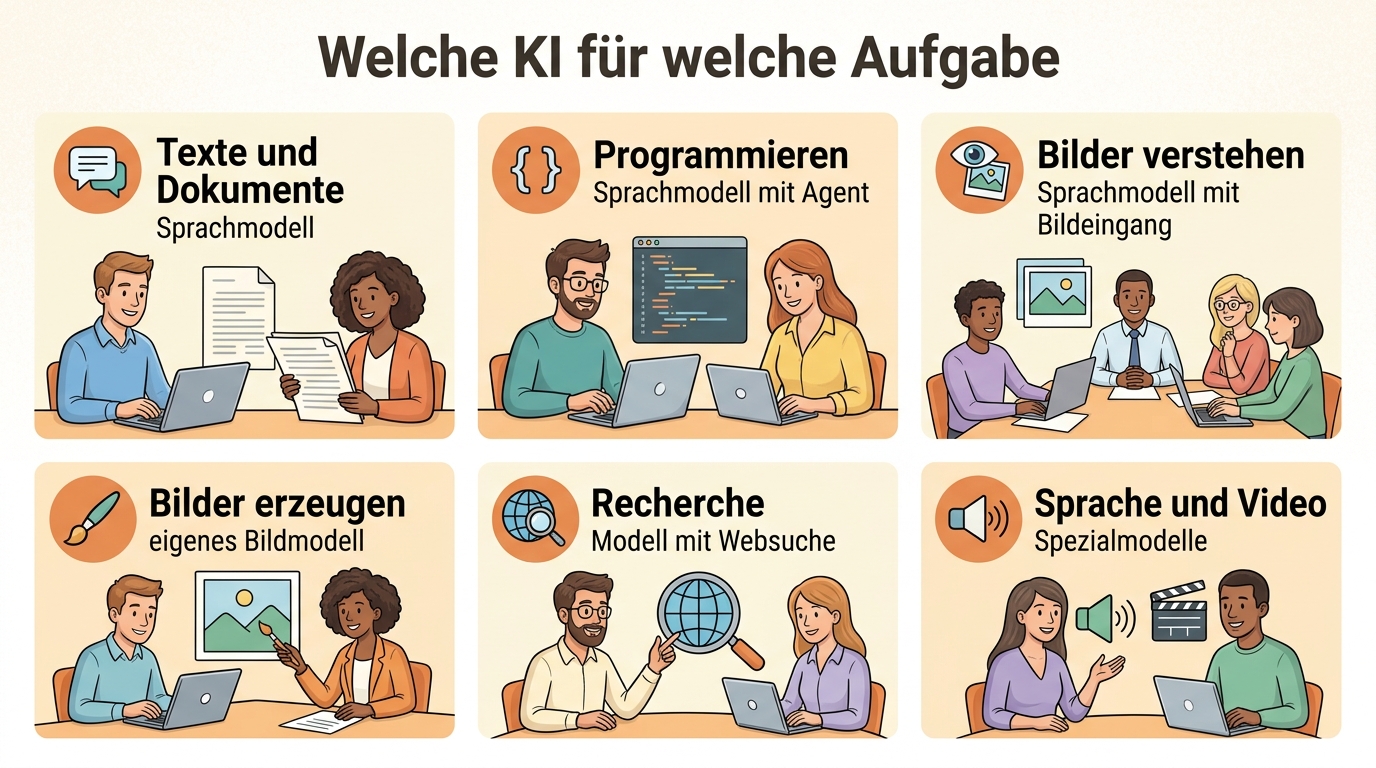
Das Ergebnis vorweg: Kein Modell gewinnt überall. Und in manchen Gebieten spielen die großen Sprachmodelle gar nicht mit, weil dort eigene Spezialmodelle arbeiten.
Die wichtigste Unterscheidung: Bilder verstehen oder Bilder erzeugen
Wer „ein Modell für Bilder“ sucht, muss zuerst klären, was gemeint ist.
Bilder verstehen heißt: Du gibst dem Modell ein Foto, einen Screenshot oder ein Diagramm, und es beschreibt, liest oder wertet aus. Das können die großen Sprachmodelle. In der Arena-Rangliste für Bildverstehen liegen Claude Fable 5 mit 1310 Punkten und Qwen3.8-Max mit 1302 Punkten vorne, Stand 13. September 2026 (Arena 2026). Claude Opus 5.5 erreicht beim Ablesen von Diagrammen im Test Chartography 89 Prozent, mit Werkzeugen (Anthropic 2026).
Bilder erzeugen heißt: Das Modell malt. Das kann nicht jedes Sprachmodell. Anthropic schreibt ausdrücklich, Claude sei nur ein Modell zum Verstehen von Bildern und könne keine Bilder erzeugen oder bearbeiten (Claude Docs 2026). Wenn ein Chatbot trotzdem ein Bild liefert, arbeitet dafür ein eigenes Bildmodell. In ChatGPT ist das GPT Image. Die neue Version GPT Image 2.5 erschien am 8. September 2026 und kommt in der API in zwei Varianten: Flare ist schneller, Sunburst detailreicher (Wikipedia 2026).
In der Arena-Rangliste für Bilderzeugung belegt OpenAI die ersten drei Plätze: GPT Image 2.5 Sunburst (1423 Punkte), GPT Image 2.5 Flare (1401) und GPT Image 2 (1381). Dahinter folgen MAI-Image-2.6 von Microsoft (1334), Grok Imagine Image 2.0 (1302) und Reve 2.1 (1301), Stand 21. September 2026 (Arena 2026). Bei der Bildbearbeitung ist die Spitze dieselbe, Googles Nano Banana Pro steht dort auf Platz 9 (Arena 2026).
Anthropic nennt die Grenzen beim Bildverstehen offen: Claude benennt keine Personen auf Bildern, zählt viele kleine Objekte nur ungefähr und kann nicht zuverlässig erkennen, ob ein Bild von einer KI stammt (Claude Docs 2026). Prüfe solche Grenzen bei jedem Anbieter, bevor du Bilder automatisch auswerten lässt.
Recherche: Modell plus Websuche
Für Recherche zählt nicht nur das Modell, sondern auch, wie gut das System drumherum sucht, liest und zitiert. Ein Beispiel ist OpenAIs Deep Research, das es seit Februar 2025 gibt: Es durchsucht selbstständig 5 bis 30 Minuten lang das Web und liefert einen Bericht mit Quellenangaben. Auch dieses Werkzeug macht gelegentlich Faktenfehler und gibt Unsicherheit nicht immer richtig wieder (Wikipedia 2026).
In der Arena-Rangliste für Websuche liegen GPT-5.6 Sol (1257 Punkte) und Claude Opus 4.6 mit Suche (1253) vorne. Die Liste stammt allerdings vom 24. August 2026 und enthält noch keines der September-Modelle (Arena 2026). Im Recherche-Test BrowseComp gibt OpenAI für GPT-6 Astra 91,5 Prozent an und für Claude Opus 5 90,8 Prozent, beide liegen also praktisch gleichauf. Das sind Herstellerangaben (OfficeChai 2026).
Warum Vorsicht angebracht ist, zeigt eine Untersuchung des Tow Center der Columbia Journalism Review. Es hat acht KI-Suchwerkzeuge mit 1.600 Anfragen getestet: Mehr als 60 Prozent der Antworten ordneten Nachrichtenartikel falsch zu, bei Perplexity 37 Prozent, bei Grok 3 94 Prozent (CJR 2025). Die getesteten Versionen sind inzwischen veraltet. Die Lehre bleibt: Bei Recherche ist das Prüfen der Quellen deine Aufgabe, nicht die des Modells.
Programmieren
In der Arena-Rangliste für Webentwicklung führt GPT-6 Astra auf höchster Aufwandsstufe mit 1793 Punkten vor Claude Fable 5.1 (1755) und Claude Opus 5 (1691) (Arena 2026). Das neue Opus 5.5 ist dort noch nicht gelistet. Anthropic meldet für Opus 5.5 im Programmiertest Terminal-Bench 4.0 einen Sprung von 52,3 auf 66,4 Prozent gegenüber Opus 5 (Anthropic 2026).
Beim Programmieren entscheidet die Umgebung stark mit, in der das Modell arbeitet. Dasselbe Modell schneidet je nach Werkzeug sehr unterschiedlich ab. Das ist das Thema von Lektion 8.
Texte und lange Dokumente
In der großen Text-Rangliste mit über 8 Millionen Stimmen liegen Claude Fable 5 (1506 Punkte, Schwankungsbreite plus oder minus 5), Claude Opus 4.6 (1505) und Claude Opus 4.7 (1502) vorne, knapp dahinter Metas Muse Spark 1.2 (1500), Stand 13. September 2026 (Arena 2026). Die Abstände sind kleiner als die Schwankungsbreite. Die ersten Plätze sind also praktisch gleichauf. Für die Arbeit mit Dokumenten wie PDFs führt Arena eine eigene Liste, dort liegen Claude Opus 5 (1516) und Claude Fable 5.1 (1513) vorne (Arena 2026).
Sprachausgabe und Video
Hier arbeiten eigene Spezialmodelle. Vorne liegen teils reine Spezialanbieter wie Cartesia, teils große Konzerne wie Google und Alibaba mit eigenen Audio- und Videomodellen.
- Sprachausgabe (Text zu Sprache): Cartesia Sonic 3.6 führt mit 1273 Punkten vor Qwen-Audio-3.0-TTS-Plus von Alibaba (1259) und Realtime TTS-2 von Inworld (1245) (Artificial Analysis 2026).
- Video (Text zu Video): Gemini Omni 1.1 Flash von Google führt mit 1516 Punkten vor Gemini Omni Flash (1513), FLUX 3 Video von Black Forest Labs (1493), Grok Imagine Video 1.5 (1492) und Seedance 2.0 von Bytedance (1479), Stand 21. September 2026 (Arena 2026).
Übersicht: Wer liegt wo vorne?
| Einsatzgebiet | Modellart | Vorne in der Rangliste | Stand |
|---|---|---|---|
| Texte schreiben | Sprachmodell | Claude Fable 5, Opus 4.6 und 4.7, Muse Spark 1.2 (praktisch gleichauf) | 13.09.2026 |
| Dokumente auswerten | Sprachmodell | Claude Opus 5, Claude Fable 5.1 | Abruf 23.09.2026 |
| Webentwicklung | Sprachmodell als Agent | GPT-6 Astra, Claude Fable 5.1 | Abruf 23.09.2026 |
| Bilder verstehen | Sprachmodell mit Bildeingang | Claude Fable 5, Qwen3.8-Max | 13.09.2026 |
| Bilder erzeugen und bearbeiten | eigenes Bildmodell | GPT Image 2.5, MAI-Image-2.6 | 21.09.2026 |
| Websuche | Sprachmodell mit Suche | GPT-5.6 Sol, Claude Opus 4.6 | 24.08.2026 |
| Sprachausgabe | Sprachsynthese-Modell | Cartesia Sonic 3.6, Qwen-Audio-3.0-TTS-Plus | Abruf 23.09.2026 |
| Video erzeugen | Videomodell | Gemini Omni 1.1 Flash, FLUX 3 Video | 21.09.2026 |
Quellen: Arena und Artificial Analysis, wie oben verlinkt.
Ranglisten nach Einsatzgebiet richtig lesen
- Schwankungsbreite beachten. Liegen zwei Modelle nur wenige Punkte auseinander und überlappen ihre Schwankungsbreiten, ist die Reihenfolge Zufall.
- Auf den Stand schauen. Ranglisten hinken hinterher. Claude Opus 5.5 fehlt in der Text-Rangliste noch, die Suchrangliste ist einen Monat alt.
- Gefallen ist nicht gleich richtig. Arena misst, welches Ergebnis Menschen im Blindvergleich besser gefällt (Arena 2026). Ob eine Antwort sachlich stimmt, prüft dieses Verfahren nicht.
- Eigene Tests zählen mehr. Ranglisten zeigen dir, welche zwei oder drei Kandidaten du ausprobieren solltest. Welcher für deine Aufgabe passt, zeigt dein eigener Test aus Lektion 7.
Zusammenfassung:
- Es gibt getrennte Ranglisten nach Einsatzgebiet, kein Modell führt überall.
- Bilder verstehen können die großen Sprachmodelle, Bilder erzeugen übernehmen eigene Bildmodelle. Dort führt derzeit GPT Image 2.5.
- Recherche hängt stark an Suche und Zitierweise, die Quellenprüfung bleibt deine Aufgabe.
- Bei Code liegen GPT-6 Astra und Claude Fable 5.1 vorne, bei Texten sind die Spitzenmodelle praktisch gleichauf.
- Für Sprachausgabe und Video führen Spezialmodelle, etwa von Cartesia, Google und Black Forest Labs.
Praxistipp: Lege dir eine kleine Werkzeugliste an: ein Sprachmodell für Texte und Code, ein Bildmodell, ein Recherchewerkzeug. So nutzt du für jede Aufgabe ein Werkzeug, das in seinem Gebiet vorne liegt.
Reflexionsfrage: Für welche deiner Aufgaben nutzt du heute ein Sprachmodell, obwohl ein Spezialmodell besser passen würde?
Lektion 7: Welches Modell wofür?
Lernziel: Du kannst für eine konkrete Aufgabe begründet ein Modell oder eine Modellkombination auswählen.
Vier Fragen vor jeder Modellwahl
- Was soll herauskommen? Ein Text, ein Stück Code, eine Entscheidung, ein Bild? Für reine Entscheidungen kommt ein Modell wie Jev in Frage, für Bilder, Sprachausgabe und Video ein Spezialmodell (Lektion 6), für alles andere ein Sprachmodell.
- Wie schwer und wie lang ist die Aufgabe? Eine Zusammenfassung braucht kein Spitzenmodell, ein mehrstündiger Programmierauftrag schon eher.
- Wie oft läuft die Aufgabe? Einmal im Monat ist der Preis fast egal, eine Million Mal im Monat entscheidet er über das Projekt.
- Welche Daten sind beteiligt? Personenbezogene oder vertrauliche Daten verlangen EU-Datenresidenz oder ein selbst betriebenes offenes Modell.
Entscheidungshilfe nach Aufgabe
| Aufgabe | Passende Modellklasse | Beispiele aus diesem Kurs |
|---|---|---|
| Lange, schwierige Programmier- und Rechercheaufträge über Stunden | Spitzenmodell | Claude Fable 5.1, GPT-6 Astra |
| Anspruchsvolle Alltagsarbeit: Code, Analysen, Konzepte | Arbeitspferd | Claude Opus 5.5 oder Sonnet 5, GPT-6 Sol |
| Große Mengen einfacher Textaufgaben: Zusammenfassen, Extrahieren | Schnellmodell | GPT-6 Luna, Gemini 3.8 Flash, Claude Haiku 4.5 |
| Viele kleine Entscheidungen: Vorsortieren, Prüfen, Weiterleiten | Entscheidungsmodell | Jev |
| Vertrauliche Daten, eigener Betrieb | Offenes Modell | Muse Glimmer (lokal), DeepSeek V4, Qwen3.8 (Server) |
| Europäische Datenhaltung in der Cloud | Modell mit EU-Datenresidenz | Gemini 3.8 Flash (innFactory 2026) |
| Bilder erzeugen und bearbeiten | Bildmodell | GPT Image 2.5 (siehe Lektion 6) |
| Recherche mit Quellen | Sprachmodell mit Websuche | Recherchemodus wie Deep Research, Quellen selbst prüfen (siehe Lektion 6) |
Das Kaskadenprinzip
In der Praxis nutzen gute KI-Anwendungen nicht ein Modell, sondern eine Kette. Ein Beispiel für einen Kundenservice:
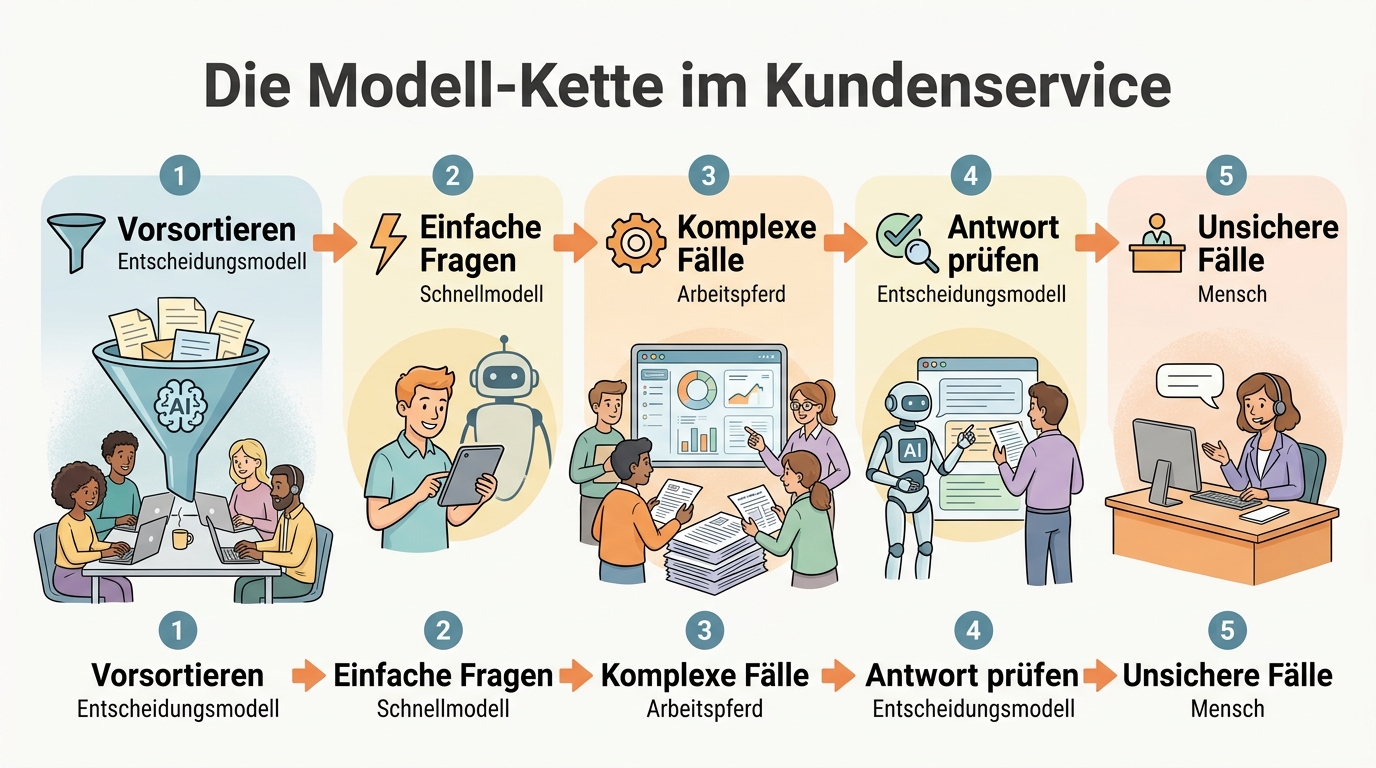
- Jev sortiert jede eingehende Anfrage vor: Thema, Dringlichkeit, Stimmung.
- Ein Schnellmodell wie GPT-6 Luna beantwortet die einfachen Standardfragen.
- Ein Arbeitspferd wie Claude Sonnet 5 übernimmt komplexe Fälle, die Recherche im Kundenkonto brauchen.
- Jev prüft jede Antwort vor dem Versand, etwa ob sie Zusagen enthält, die nicht gegeben werden dürfen.
- Ein Mensch bekommt alles, bei dem die Konfidenz unter einem festgelegten Schwellenwert liegt.
So landet jede Anfrage beim günstigsten Modell, das sie zuverlässig lösen kann. Das Spitzenmodell brauchst du in dieser Kette vielleicht gar nicht.
Die Aufwandsstufe als zweiter Regler
Bevor du zu einem größeren Modell wechselst, probiere eine höhere Aufwandsstufe beim bisherigen. Anthropic empfiehlt genau diese Reihenfolge: erst Opus 5.5 mit höherem Aufwand, erst danach Fable 5.1 (Claude Docs 2026). Behalte dabei die Kosten im Blick: Auf der höchsten Stufe verbraucht Opus 5.5 deutlich mehr Token als auf den niedrigeren und als manches Konkurrenzmodell (siehe Lektion 4).
Eigene Tests schlagen Ranglisten
Ranglisten sind ein guter Startpunkt, aber sie widersprechen sich oft, weil sie unterschiedliche Versionen und Methoden nutzen. Belastbar ist nur, was du mit deinen eigenen Aufgaben misst. Ein einfacher Ablauf:
- Sammle 20 bis 50 echte Beispiele aus deiner Arbeit, bei denen du die richtige Antwort kennst.
- Lass zwei bis drei Modelle aus verschiedenen Stufen daran arbeiten.
- Bewerte Qualität, Dauer und Kosten pro erledigter Aufgabe.
- Nimm das günstigste Modell, das deine Qualitätsschwelle erreicht.
Zusammenfassung:
- Vier Fragen klären die Modellwahl: Ergebnisart, Schwierigkeit, Häufigkeit, Datenschutz.
- Für jede Aufgabenklasse gibt es eine passende Modellklasse, das Spitzenmodell ist selten die beste Wahl.
- Kaskaden aus Entscheidungsmodell, Schnellmodell, Arbeitspferd und Mensch verbinden Qualität und Kosten.
- Erst die Aufwandsstufe erhöhen, dann das Modell wechseln.
- Eigene Tests mit echten Beispielen sind verlässlicher als jede Rangliste.
Praxistipp: Nimm dir eine wiederkehrende Aufgabe aus deinem Alltag und teste sie diese Woche mit einem Schnellmodell. Viele Aufgaben, für die du bisher das große Modell genutzt hast, erledigt das kleine genauso gut.
Lektion 8: Die Harness: Kontext, Werkzeuge und alles um das Modell herum
Lernziel: Du verstehst, was eine Harness ist, warum sie Qualität und Kosten oft so stark beeinflusst wie die Modellwahl und wie du den Kontext eines Modells gezielt gestaltest.
Motor und Auto
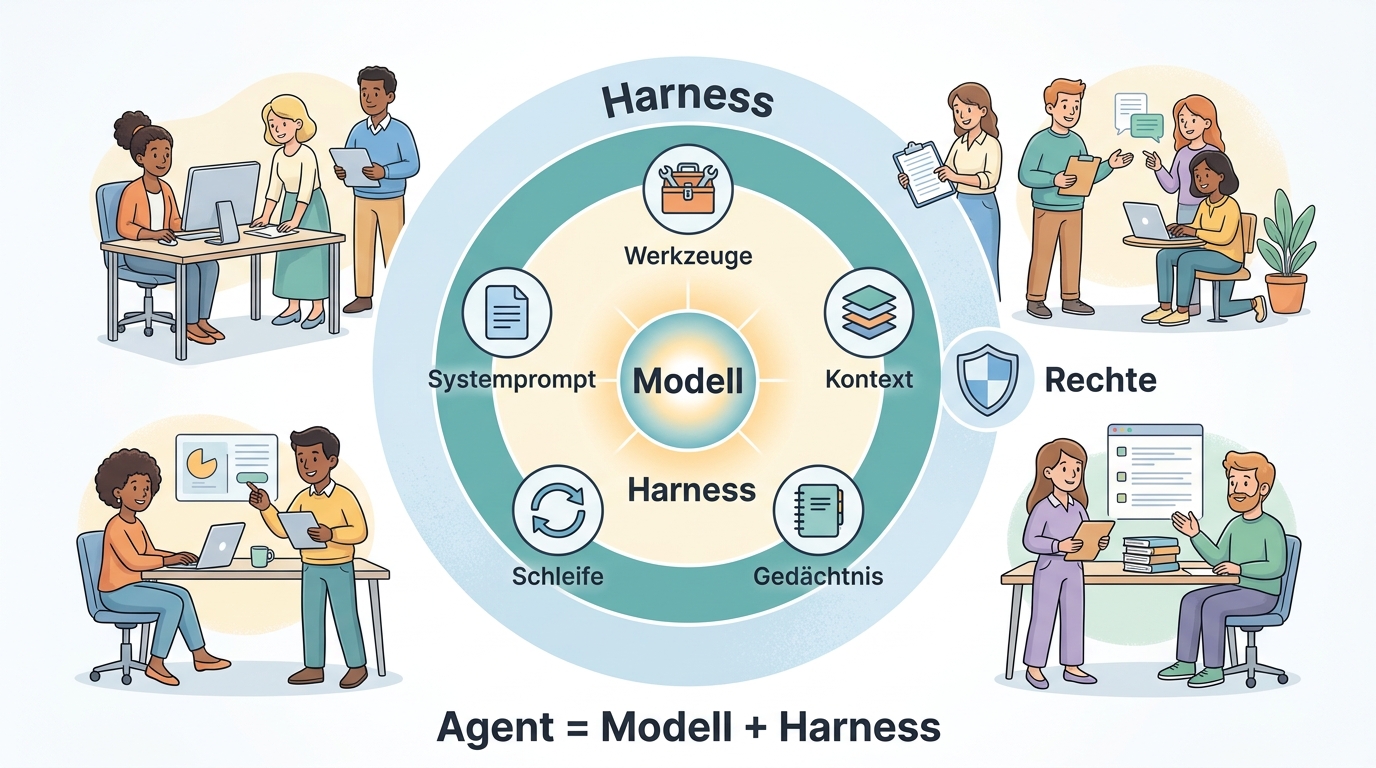
Ein Sprachmodell allein ist wie ein Motor auf dem Prüfstand: stark, aber es fährt nirgendwohin. Das Modell nimmt Text entgegen und gibt Text zurück. Es hat kein Gedächtnis zwischen zwei Aufrufen und keine eigene Arbeitsschleife (Hugging Face 2026). Alles, was aus dem Motor ein Auto macht, heißt Harness. Das englische Wort bedeutet so viel wie Geschirr oder Kabelbaum. Hugging Face bringt es auf eine Formel: Agent = Modell + Harness (ebd.).
Hugging Face unterscheidet genau genommen zwei Schichten. Das Scaffolding legt das Verhalten fest: Systemprompt, Beschreibungen der Werkzeuge, Auswertung der Modellantworten und die Frage, was sich das System von Schritt zu Schritt merkt. Die Harness im engeren Sinn führt aus: Sie ruft das Modell auf, führt dessen Werkzeugaufrufe aus und entscheidet, wann Schluss ist (ebd.). In der Praxis wird beides meist zusammen Harness genannt. Cursor etwa zählt Systemprompts, Werkzeugbeschreibungen und die Verwaltung des Kontextfensters ausdrücklich zur Harness (Cursor 2026). So verwendet auch dieser Kurs den Begriff.
Du benutzt Harnesses jeden Tag: Die ChatGPT-App, die Claude-App, Programmierwerkzeuge wie Claude Code, Codex und Cursor sind alle Harnesses um ein Modell herum. Wenn du in der App das Modell umschaltest, tauschst du den Motor und behältst das Auto.
Die Bausteine einer Harness
- Systemprompt: Grundanweisungen, die vor jedem Gespräch stehen, etwa zu Rolle, Tonfall und Regeln.
- Werkzeuge: Websuche, Dateien lesen und schreiben, Code ausführen, Programme bedienen. Dazu gehört jeweils eine Beschreibung, wann das Modell welches Werkzeug nutzen soll. Laut Anthropic bringen schon kleine Verbesserungen an diesen Beschreibungen oft deutliche Verbesserungen (Anthropic 2025).
- Kontext: alles, was das Modell in einem Moment tatsächlich sieht. Mehr dazu gleich.
- Gedächtnis: Notizen, die außerhalb des Kontextfensters gespeichert und bei Bedarf wieder hineingeladen werden (Anthropic 2025).
- Schleife: Modell aufrufen, Werkzeug ausführen, Ergebnis zurückgeben, wiederholen, bis die Aufgabe erledigt ist (Hugging Face 2026).
- Rechte: Was darf der Agent ohne Rückfrage tun, was nur nach Freigabe, was nie?
Warum die Harness so viel ausmacht
Zwei Messungen aus diesem Jahr zeigen, wie groß der Einfluss ist.
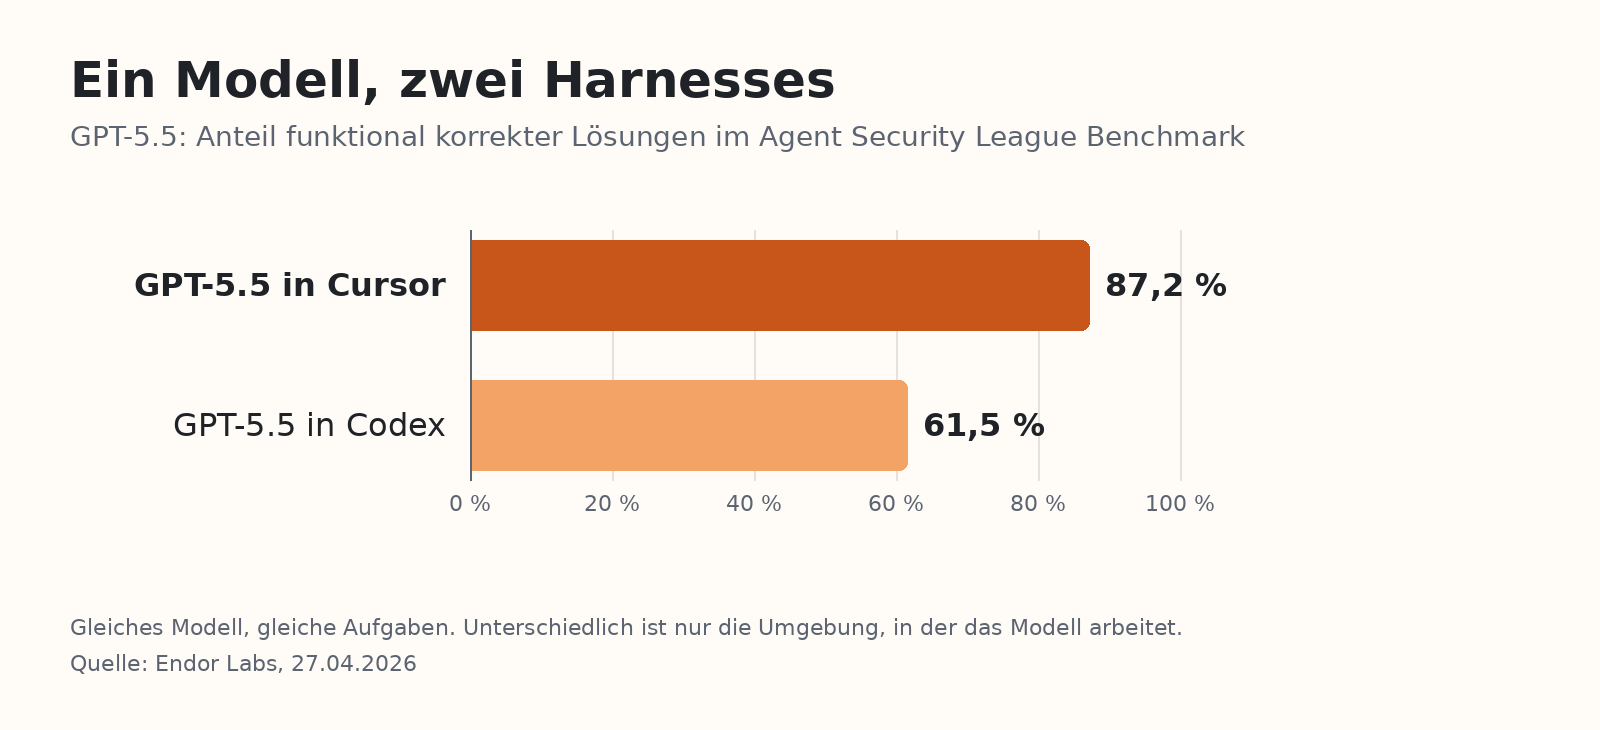
Erstens die Qualität. Endor Labs hat GPT-5.5 in zwei Umgebungen dieselben Programmieraufgaben lösen lassen. In Cursor waren 87,2 Prozent der Lösungen funktional korrekt, in OpenAIs eigenem Werkzeug Codex 61,5 Prozent (Endor Labs 2026). Dasselbe Modell, ein Unterschied von fast 26 Prozentpunkten.
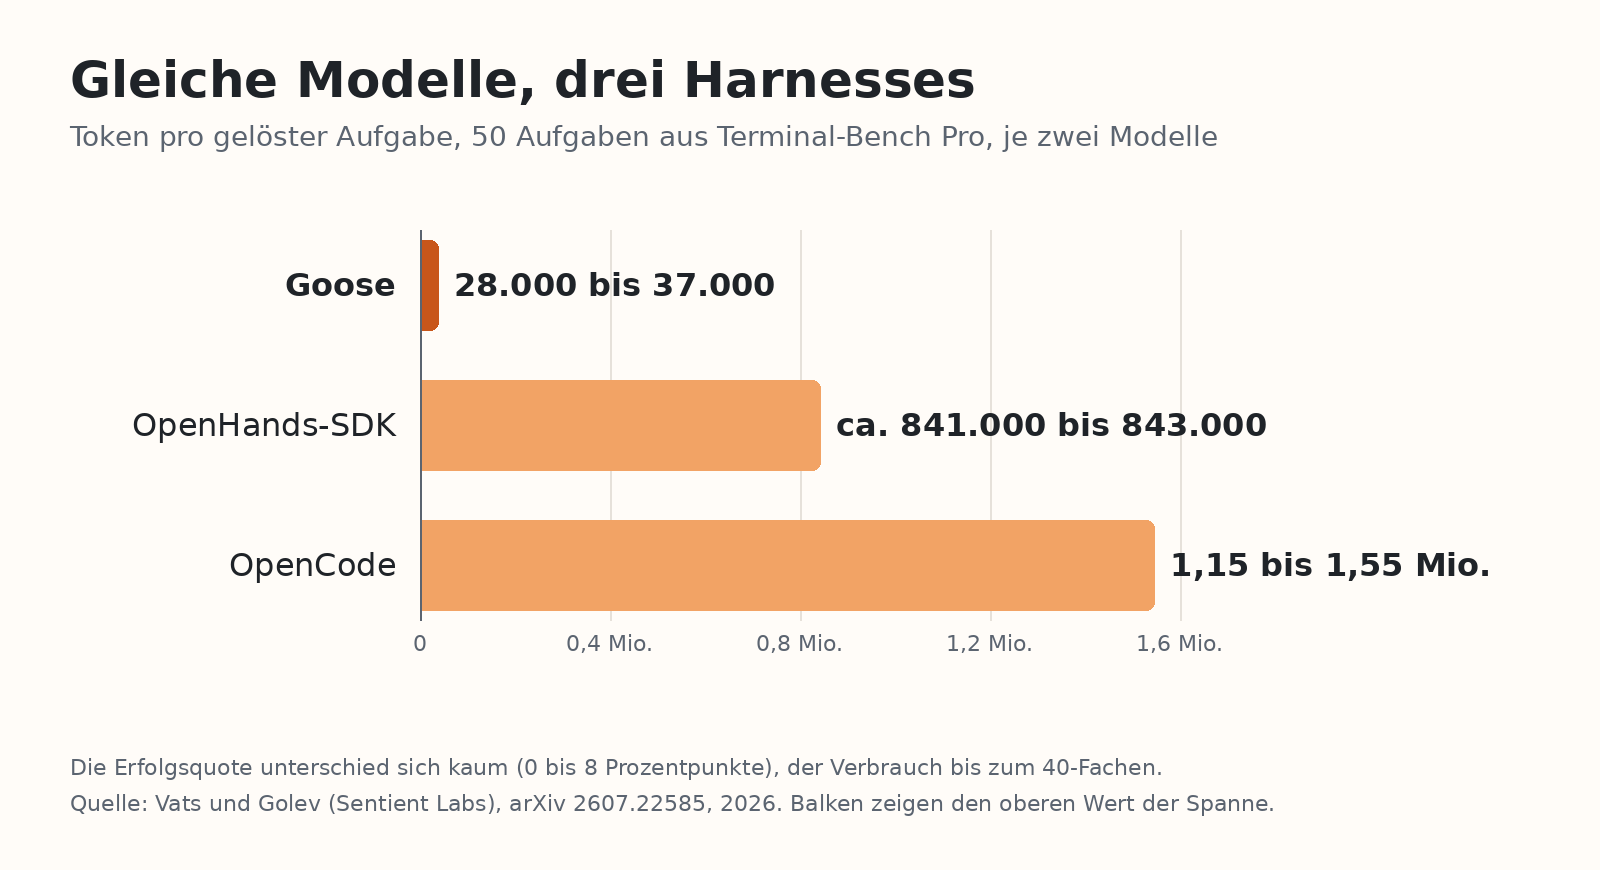
Zweitens die Kosten. Forscher von Sentient Labs haben zwei Modelle in drei offenen Harnesses an 50 Aufgaben aus Terminal-Bench Pro getestet. Die Erfolgsquoten unterschieden sich nur um 0 bis 8 Prozentpunkte, das lag im Bereich des Zufalls. Der Verbrauch dagegen unterschied sich massiv: Pro gelöster Aufgabe brauchte Goose rund 28.000 bis 37.000 Token, OpenCode rund 1,15 bis 1,55 Millionen. Das ist bis zum 40-Fachen. Der Wechsel auf das bessere Modell veränderte die Kosten dagegen nur um das 1,0- bis 1,3-Fache (Vats und Golev 2026).
Warum ist das so? Modelle sind auf bestimmte Arbeitsweisen trainiert. Cursor beschreibt, dass die Modelle von OpenAI Dateien in einem Patch-Format bearbeiten, die von Anthropic per Textersetzung. Cursor passt seine Harness deshalb für jedes Modell eigens an. Die Firma schreibt: Harness und Modell bestimmen gemeinsam, wie gut der Agent ist (Cursor 2026).
Für dich heißt das: Eine Benchmark-Zahl ohne Angabe der Harness ist nur die halbe Information. Und bevor du das Modell wechselst, lohnt der Blick auf die Harness.
Der Kontext: das Arbeitsgedächtnis des Modells
In Lektion 1 hast du das Kontextfenster kennengelernt: Bei den Spitzenmodellen passt eine Million Token hinein. Das heißt aber nicht, dass du es füllen solltest.
Das Unternehmen Chroma hat 2025 achtzehn Sprachmodelle getestet. Ergebnis: Mit wachsender Eingabelänge werden die Antworten unzuverlässiger, auch bei einfachen Aufgaben, und die Modelle nutzen ihren Kontext nicht gleichmäßig (Chroma 2025). Diese Erscheinung heißt Context Rot, frei übersetzt: Der Kontext verdirbt. Die getesteten Modelle sind älter als die aus diesem Kurs. Anthropic beschreibt das Problem aber weiterhin als Grundregel: Ein Modell hat ein begrenztes Aufmerksamkeitsbudget, und jedes zusätzliche Token verbraucht einen Teil davon (Anthropic 2025).
Daraus ist ein eigenes Fach entstanden, das Kontext-Engineering. Anthropic definiert es als die Strategien, mit denen man während der Arbeit des Modells die bestmögliche Auswahl an Informationen zusammenstellt und pflegt, auch alles, was außerhalb des eigentlichen Prompts dort landet (ebd.). Vier Techniken stehen im Mittelpunkt (ebd.):
- Verdichten: Wird der Kontext voll, fasst die Harness den bisherigen Verlauf zusammen und arbeitet mit der Zusammenfassung weiter.
- Notizen führen: Der Agent schreibt Zwischenstände in Dateien außerhalb des Kontextfensters und holt sie bei Bedarf zurück.
- Unteragenten: Spezialisierte Agenten bearbeiten Teilaufgaben mit frischem, sauberem Kontext und liefern nur eine kurze Zusammenfassung zurück.
- Abruf bei Bedarf: Statt alles vorab hineinzuladen, merkt sich der Agent nur, wo etwas liegt, und lädt es mit Werkzeugen, wenn er es braucht.
Lange Aufgaben: die Harness als Projektleitung
Richtig wichtig wird die Harness bei Aufgaben, die länger dauern, als ein Kontextfenster reicht. Anthropic beschreibt das Grundproblem so: Ein Agent arbeitet in einzelnen Sitzungen, und jede neue Sitzung beginnt ohne Erinnerung an die vorherige (Anthropic 2025). Zwei Fehler sind typisch: Der Agent will alles auf einmal erledigen und bricht mittendrin ab, oder eine spätere Sitzung erklärt das Projekt vorschnell für fertig (ebd.).
Die Lösung, die Anthropic beschreibt, klingt nach gutem Projektmanagement (ebd.):
- Ein erster Agent legt eine Liste aller Anforderungen an, im Beispiel mehr als 200, zunächst alle als „nicht erfüllt“ markiert, dazu eine Fortschrittsdatei.
- Jede weitere Sitzung liest zuerst die Fortschrittsdatei, prüft den Stand und nimmt sich genau eine Anforderung vor.
- Erst nach einem echten Test wird die Anforderung als erledigt markiert, der Stand wird gesichert und die Fortschrittsdatei aktualisiert.
Das Prinzip lässt sich auf Büroarbeit übertragen: Wer einen KI-Assistenten über Tage an einem Projekt arbeiten lässt, gibt ihm eine Projektdatei mit Ziel, erledigten Schritten und offenen Punkten und lässt sie nach jedem Schritt fortschreiben.
Was das für dich heißt
Wenn du KI-Apps nutzt:
- Gib dem Modell nur die Dokumente, die es für die Aufgabe braucht, nicht vorsichtshalber alle.
- Nutze feste Anweisungen oder Projektfunktionen deiner App für alles, was immer gelten soll, statt es in jedes Gespräch neu zu tippen.
- Wird ein Gespräch sehr lang und die Antworten schlechter, lass dir eine Zusammenfassung schreiben und beginne damit ein neues Gespräch. Das ist Verdichten von Hand.
Wenn du KI-Anwendungen baust oder auswählst:
- Vergleiche immer die Kombination aus Modell und Harness, nie das Modell allein.
- Miss den Verbrauch pro erledigter Aufgabe. Die Harness kann ihn stärker verändern als der Modellwechsel.
- Pflege die Beschreibungen deiner Werkzeuge so sorgfältig wie einen Prompt.
- Lege die Rechte des Agenten fest, bevor er arbeitet, nicht danach.
Zusammenfassung:
- Agent = Modell + Harness. Die Harness umfasst Systemprompt, Werkzeuge, Kontext, Gedächtnis, Arbeitsschleife und Rechte.
- Dasselbe Modell kann in zwei Harnesses um fast 26 Prozentpunkte unterschiedlich abschneiden oder bis zum 40-Fachen an Token verbrauchen.
- Ein großes Kontextfenster ist kein Freibrief: Mit wachsendem Kontext werden Modelle unzuverlässiger.
- Kontext-Engineering arbeitet mit vier Techniken: verdichten, Notizen führen, Unteragenten, Abruf bei Bedarf.
- Lange Aufgaben brauchen eine Harness, die wie eine Projektleitung arbeitet: Anforderungsliste, Fortschrittsdatei, ein Schritt nach dem anderen.
Praxistipp: Nimm dein nächstes langes KI-Gespräch und starte es nach der Hälfte neu, mit einer vom Modell geschriebenen Zusammenfassung als Einstieg. Vergleiche, ob die Antworten danach präziser werden.
Reflexionsfrage: Wenn dein KI-Werkzeug schlechte Ergebnisse liefert: Liegt es am Modell, oder an dem, was du ihm in den Kontext gibst?
Lektion 9: Aussichten, was als Nächstes kommt
Lernziel: Du kennst die absehbaren nächsten Schritte im Markt und kannst eine Strategie ableiten, die nicht bei jeder Neuerscheinung umgeworfen werden muss.
Was angekündigt ist
- Qwen 4: Alibaba hat am 22. September 2026 vier Stufen angekündigt, Qwen 4 Max, Flash, Plus und ein offenes Modell mit 27 Milliarden Parametern. Preise, Termine und Leistungsdaten gibt es noch nicht (OrcaRouter 2026).
- Claude Sonnet 5.5 und Haiku 5.5: Anthropic hat beide für die kommenden Wochen angekündigt, mit ähnlichen Verbesserungen wie bei Opus 5.5 (TechCrunch 2026). Wer heute Claude Haiku 4.5 einsetzt, sollte den Wechsel einplanen: Anthropic schaltet Haiku 4.5 frühestens am 15. Oktober 2026 ab, eine längere Zusage gibt es nicht (Claude Docs 2026).
- Gemini 3.5 Pro: ursprünglich für Juni 2026 angekündigt, verschoben ohne neuen Termin (innFactory 2026).
- Mistrals neue offene Modellfamilie: seit Juli im Early Access, ohne öffentliche Daten (Digital Applied 2026).
- Preiserhöhung bei Gemini 3.8 Flash: ab 1. Januar 2027 doppelter Preis (innFactory 2026). Wer jetzt darauf plant, sollte das einrechnen.
Was sich bei der Regulierung tut
Die Pflichten für Anbieter von KI-Modellen mit allgemeinem Verwendungszweck gelten nach dem EU AI Act seit August 2025, die Durchsetzung durch die Behörden beginnt im August 2026 (Jähne Günther 2026). Mit dem Digital Omnibus, in Kraft seit dem 27. Juli 2026, wurden die Pflichten für Hochrisiko-KI-Systeme verschoben: für eigenständige Systeme nach Anhang III auf den 2. Dezember 2027, für in Produkte eingebettete Systeme nach Anhang I auf den 2. August 2028 (Technovice 2026).
Drei Entwicklungen, die du beobachten solltest
1. Die Lücke zwischen offen und geschlossen. Anfang September betrug sie 9 Punkte (24/7 Wall St. 2026), mit Opus 5.5 ist sie auf 14 Punkte gewachsen (Artificial Analysis 2026). Die spannende Frage ist, ob Qwen 4 und die neue Mistral-Familie sie wieder verkleinern. Wird die Lücke kleiner, wird es für die Anbieter der Spitzenmodelle schwerer, ihre Preise zu rechtfertigen. Für dich als Nutzer steigt die Verhandlungsmacht, und die Option, sensible Aufgaben selbst zu betreiben, wird attraktiver.
2. Die Länge autonomer Arbeit. Setzt sich der von METR gemessene Trend fort, verdoppelt sich die Dauer von Aufgaben, die KI-Agenten zuverlässig schaffen, in wenigen Monaten (METR 2026). Die entscheidende Frage für Unternehmen verschiebt sich damit von „Kann die KI das?“ zu „Wie kontrollieren wir, was sie tut?“.
3. Spezialisierte Modelle für Maschinen. Jev ist ein früher Vertreter einer Idee: Nicht jede KI muss mit Menschen sprechen. Ob das Konzept trägt, entscheidet sich an unabhängigen Tests, die es bisher nicht gibt (Wavect 2026). Die Wette von TypeSafe steckt im Namen: Werden KI-Entscheidungen billig genug, wird KI auch dort eingesetzt, wo sie sich bisher nicht gerechnet hat (Wikipedia 2026).
Eine Strategie, die Neuerscheinungen übersteht
- Baue austauschbar. Binde Modelle so ein, dass du sie wechseln kannst, ohne deine Anwendung neu zu schreiben. Bei dem Tempo aus Lektion 1 ist das wichtigste Merkmal einer KI-Architektur, dass sie ein neues Modell in Tagen statt Monaten aufnehmen kann.
- Halte deine Testsammlung aktuell. Die 20 bis 50 Beispiele aus Lektion 7 sind dein Messinstrument für jedes neue Modell. Damit prüfst du eine Neuerscheinung an einem Nachmittag.
- Plane mit Kosten pro Aufgabe. Preise pro Token fallen, Token pro Aufgabe steigen. Beobachte beides.
- Bewerte Modell und Harness gemeinsam. Ein neues Modell zeigt seine Stärke nur in einer Harness, die auf das Modell abgestimmt ist (Lektion 8).
- Prüfe Lizenz und Datenstandort zuerst. Das beste Modell nützt nichts, wenn du es rechtlich nicht einsetzen darfst.
Zusammenfassung:
- Angekündigt sind Claude Sonnet 5.5 und Haiku 5.5, Qwen 4, Gemini 3.5 Pro und eine neue Mistral-Familie.
- Der EU AI Act wird für Modellanbieter ab August 2026 durchgesetzt, Hochrisiko-Pflichten sind auf Ende 2027 und 2028 verschoben.
- Zu beobachten: Abstand offen zu geschlossen, Länge autonomer Arbeit, spezialisierte Modelle.
- Die robusteste Strategie: austauschbar bauen, eigene Tests pflegen, Kosten pro Aufgabe messen, Modell und Harness gemeinsam bewerten, Lizenzen zuerst prüfen.
Reflexionsfrage: Wie lange würde es in deinem Unternehmen dauern, das eingesetzte KI-Modell gegen ein anderes auszutauschen? Tage, Wochen oder Monate?
Gesamtzusammenfassung
- Der Markt im Herbst 2026: Im September haben alle großen Anbieter neue Modelle veröffentlicht. Modelle kommen in Familien mit Spitzenmodell, Arbeitspferd und Schnellmodell, zwischen denen bei OpenAI der Preisfaktor 100 liegt.
- Geschlossene Spitzenmodelle: Claude Opus 5.5 führt seit dem 22. September die Rangliste von Artificial Analysis an und kostet 4 und 20 US-Dollar pro Million Token, weniger als die Hälfte von GPT-6 Astra und Claude Fable 5.1 (je 10 und 50 US-Dollar). Auf höchster Aufwandsstufe verbraucht es aber viele Token. Günstigere Stufen bieten GPT-6 Sol, Claude Sonnet 5, GPT-6 Luna und Gemini 3.8 Flash.
- Offene Modelle: Kimi K3, GLM-5.3, DeepSeek V4 und Qwen3.8 lagen Anfang September 9 Punkte hinter der Spitze, seit Opus 5.5 sind es 14. Lizenzen entscheiden über die Nutzbarkeit, Llama 4 ist für EU-Organisationen ausgeschlossen.
- Die großen Entwicklungen: Reasoning mit Aufwandsstufen, Agenten mit schnell wachsender Arbeitsdauer, fallende Preise bei steigendem Tokenverbrauch, Sicherheit als Verfügbarkeitsfaktor, Spezialisierung.
- Jev: Ein Modell von TypeSafe AI, das keine Texte schreibt, sondern kalibrierte Entscheidungen liefert, für 0,042 US-Dollar pro Million Eingabe-Token. Stark für Vorsortieren und Prüfen, schwächer auf Deutsch, Herstellerzahlen noch nicht unabhängig bestätigt.
- Einsatzgebiete: Für Texte, Code, Bildverstehen, Bilderzeugung, Websuche, Sprachausgabe und Video gibt es getrennte Ranglisten. Bilder erzeugen eigene Bildmodelle wie GPT Image 2.5, Claude etwa kann Bilder nur verstehen. Bei Recherche bleibt die Quellenprüfung deine Aufgabe.
- Modellwahl: Vier Fragen (Ergebnis, Schwierigkeit, Häufigkeit, Daten) führen zur passenden Modellklasse. Kaskaden verbinden mehrere Modelle, eigene Tests schlagen Ranglisten.
- Harness: Agent = Modell + Harness. Dasselbe Modell kann je nach Harness fast 26 Prozentpunkte besser abschneiden oder bis zum 40-Fachen an Token verbrauchen. Kontext ist ein knappes Arbeitsgedächtnis, das man mit Verdichten, Notizen, Unteragenten und Abruf bei Bedarf gezielt gestaltet.
- Aussichten: Claude Sonnet 5.5 und Haiku 5.5, Qwen 4, Gemini 3.5 Pro und neue Mistral-Modelle stehen an. Wer austauschbar baut und mit eigenen Tests misst, muss seine Strategie nicht bei jeder Neuerscheinung umwerfen.
Das Wichtigste zum Schluss: Das beste Modell gibt es nicht. Es gibt das passende Modell in der passenden Harness für eine Aufgabe, und das findest du mit deinen eigenen Beispielen schneller als mit jeder Rangliste.
Quellenverzeichnis
- 24/7 Wall St. (2026): Open-weights AI models now sit just 9 points behind GPT-6 and Claude. https://247wallst.com/cards/xpost-01m1yj852p230gg5tksfn4q7bh
- AI Release Tracker (2026): Mistral Models. https://aireleasetracker.com/company/mistral
- Anthropic (2025): Effective context engineering for AI agents. https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- Anthropic (2025): Effective harnesses for long-running agents. https://www.anthropic.com/engineering/effective-harnesses-for-long-running-agents
- Anthropic (2025): Writing effective tools for agents. https://www.anthropic.com/engineering/writing-tools-for-agents
- Anthropic (2026): Claude Fable. https://www.anthropic.com/claude/fable
- Anthropic (2026): Introducing Claude Opus 5.5. https://www.anthropic.com/claude-opus-5-5
- Arena (2026): Image Edit Leaderboard. https://arena.ai/leaderboard/image-edit
- Arena (2026): Leaderboard, Übersicht aller Kategorien. https://arena.ai/leaderboard
- Arena (2026): Search Leaderboard. https://arena.ai/leaderboard/search
- Arena (2026): Text Leaderboard. https://arena.ai/leaderboard/text
- Arena (2026): Text-to-Image Leaderboard. https://arena.ai/leaderboard/text-to-image
- Arena (2026): Text-to-Video Leaderboard. https://arena.ai/leaderboard/text-to-video
- Arena (2026): Vision Leaderboard. https://arena.ai/leaderboard/vision
- Artificial Analysis (2026): Claude Opus 5.5 takes the top spot on the Artificial Analysis Intelligence Index. https://artificialanalysis.ai/articles/claude-opus-5-5
- Artificial Analysis (2026): Text to Speech Leaderboard. https://artificialanalysis.ai/text-to-speech/leaderboard
- BornCity (2026): Jev-Start: 140.000 Entwickler registrieren sich in 36 Stunden. https://borncity.com/news/jev-start-140-000-entwickler-registrieren-sich-in-36-stunden/
- CellCog (2026): DeepSeek Opens V4-Flash-Vision-Exp. https://cellcog.ai/blog/deepseek-v4-flash-vision-exp/
- Chroma (2025): Context Rot: How Increasing Input Tokens Impacts LLM Performance. https://www.trychroma.com/research/context-rot
- Claude Docs (2026): Claude Fable 5.1. https://platform.claude.com/docs/de/models/fable-5-1/overview
- Claude Docs (2026): Models overview. https://platform.claude.com/docs/en/about-claude/models/overview
- Claude Docs (2026): Vision. https://platform.claude.com/docs/en/build-with-claude/vision
- Codersera (2026): Grok 4.6 Release Date. https://codersera.com/blog/grok-4-6-launch-guide-2026/
- Columbia Journalism Review, Tow Center (2025): AI Search Has A Citation Problem. https://www.cjr.org/tow_center/we-compared-eight-ai-search-engines-theyre-all-bad-at-citing-news.php
- Cursor (2026): Continually improving our agent harness. https://cursor.com/blog/continually-improving-agent-harness
- Devoriales (2026): Kimi K3 Open Weights: What Moonshot Actually Shipped. https://devoriales.com/kimi-k3-open-weights-what-moonshot-actually-shipped
- Digital Applied (2026): Open-Weight Models: The Announcement-to-Release Gap. https://www.digitalapplied.com/blog/open-weight-announcement-to-weights-gap-ledger
- Endor Labs (2026): GPT-5.5 Sets a New Code Security Record with Cursor, not Codex. https://www.endorlabs.com/learn/gpt-5-5-sets-a-new-code-security-record-with-cursor-not-codex-in-agent-security-league
- Epoch AI (2025): LLM inference prices have fallen rapidly but unequally across tasks. https://epoch.ai/data-insights/llm-inference-price-trends
- heise online (2026): Claude Fable 5.1 setzt sich in Benchmarks an die Spitze. https://www.heise.de/news/Anthropic-legt-bei-Claude-nach-Fable-5-1-uebernimmt-Benchmark-Fuehrung-11437935.html
- heise online (2026): Das KI-Modell „Jev“ liefert Entscheidungen statt Texte. https://www.heise.de/news/KI-Modell-Jev-soll-Maschinen-schneller-entscheiden-lassen-11456995.html
- Hugging Face (2026): Harness, Scaffold, and the AI Agent Terms Worth Getting Right. https://huggingface.co/blog/agent-glossary
- innFactory (2026): Google Gemini: Versionen, Benchmarks und EU-Verfügbarkeit. https://innfactory.ai/de/ki-modelle/google-gemini/
- innFactory (2026): Jev von TypeSafe. https://innfactory.ai/de/blog/jev-system-one-modell-klassifizierer-statt-llm/
- innFactory (2026): Meta Llama und Muse. https://innfactory.ai/de/ki-modelle/meta-llama/
- Jähne Günther Rechtsanwälte (2026): KI-Verordnung reformiert. https://www.jaehne-guenther.de/ki-verordnung-reformiert/
- METR (2026): Time Horizon 1.1. https://metr.org/blog/2026-1-29-time-horizon-1-1/
- MorphLLM (2026): DeepSeek V4: Specs, Pricing, Benchmarks. https://www.morphllm.com/deepseek-v4
- NDTV Profit (2026): What Is Jev? https://www.ndtvprofit.com/technology/what-is-jev-the-ultra-cheap-ai-model-from-chatgpt-s-creator-disrupting-costly-llm-agents-12081020
- OfficeChai (2026): Claude Opus 5.5 Jumps To Top Spot On Artificial Analysis Intelligence Index. https://officechai.com/ai/claude-opus-5-5-creates-5-point-lead-over-gpt-6-astra-jumps-to-top-spot-on-artificial-analysis-intelligence-index/
- OfficeChai (2026): These Are The Official OpenAI GPT-6 Astra Benchmarks. https://officechai.com/ai/gpt-6-astra-benchmarks/
- OpenAI (2026): GPT-6 Astra System Card. https://deploymentsafety.openai.com/gpt-6-astra
- OpenAI (2026): GPT-6 Astra: Die nächste Generation der Intelligenz für die Arbeit. https://openai.com/de-DE/index/gpt-6-astra-next-generation-work/
- OrcaRouter (2026): Qwen 4 Max auf der Apsara 2026 angekündigt. https://www.orcarouter.ai/de/blog/qwen-4-max-lineup-announced-apsara-2026
- TechCrunch (2026): Anthropic releases Opus 5.5 with lower prices and Fable-level performance. https://techcrunch.com/2026/09/22/anthropic-releases-opus-5-5-with-lower-prices-and-fable-level-performance/
- TechCrunch (2026): OpenAI launches GPT-6 Sol and Luna. https://techcrunch.com/2026/09/22/openai-launches-gpt-6-sol-and-luna/
- Technovice (2026): KI-Kennzeichnungspflicht 2026. https://www.technovice.net/de/post/ki-kennzeichnungspflicht-eu-ai-act-2026
- The Decoder (2026): Claude Opus 5.5 matches Fable 5.1 performance at lower cost. https://the-decoder.com/claude-opus-5-5-matches-fable-5-1-at-40-percent-lower-cost-as-anthropic-promises-to-fix-claudish-writing/
- the-decoder (2026): Ex-OpenAI-Forscher stellt KI-Modell vor, das keine Texte schreibt. https://the-decoder.de/ex-openai-forscher-stellt-ki-modell-vor-das-keine-texte-schreibt-sondern-entscheidungen-bewertet/
- Vats, N. und Golev, O. (2026): The Scaffold Effect in Coding Agents. arXiv 2607.22585. https://arxiv.org/html/2607.22585
- VentureBeat (2026): Goodbye, Llama? Meta launches new proprietary AI model Muse Spark. https://venturebeat.com/technology/goodbye-llama-meta-launches-new-proprietary-ai-model-muse-spark-first-since
- VentureBeat (2026): OpenAI releases GPT-6 Sol and Luna models. https://venturebeat.com/technology/openai-releases-gpt-6-sol-and-luna-models-slashing-api-costs-50-or-more
- Wavect (2026): Jev AI im Test: Entscheidungsmodelle für Agenten. https://wavect.io/de/blog/jev-ai-decision-model-review/
- Wikipedia (2026): ChatGPT Deep Research. https://en.wikipedia.org/wiki/ChatGPT_Deep_Research
- Wikipedia (2026): GPT Image. https://en.wikipedia.org/wiki/GPT_Image
- Wikipedia (2026): GPT-6 Astra. https://en.wikipedia.org/wiki/GPT-6_Astra
- Wikipedia (2026): Jev (AI model). https://en.wikipedia.org/wiki/Jev_%28AI_model%29
- xAI (2026): Release Notes. https://docs.x.ai/developers/release-notes
- Yotta Labs (2026): GPT-6 Astra: Release Date, Pricing, Benchmarks, and Rollout. https://www.yottalabs.ai/post/gpt-6-release-date-rumors-what-is-known-2026
- ZEIT (2026): Cohere-Chef: Talente von Aleph Alpha bleiben in Deutschland. https://www.zeit.de/news/2026-06/01/cohere-chef-talente-von-aleph-alpha-bleiben-in-deutschland